日々のライフログや AI に渡すコンテキストを、BigQuery に貯めています。そのデータを Claude Code に集計してもらうとき、これまでは Claude Code がターミナルで bq query コマンドを打って取り出していました。
便利ではあるものの、bq コマンドは自分のアカウントでできることが全部できます。私のアカウントはプロジェクトのオーナーなので、テーブルの削除も、何TBもあるテーブルの全件読み込みもできてしまいます。AI に任せるには、少し怖い状態でした。
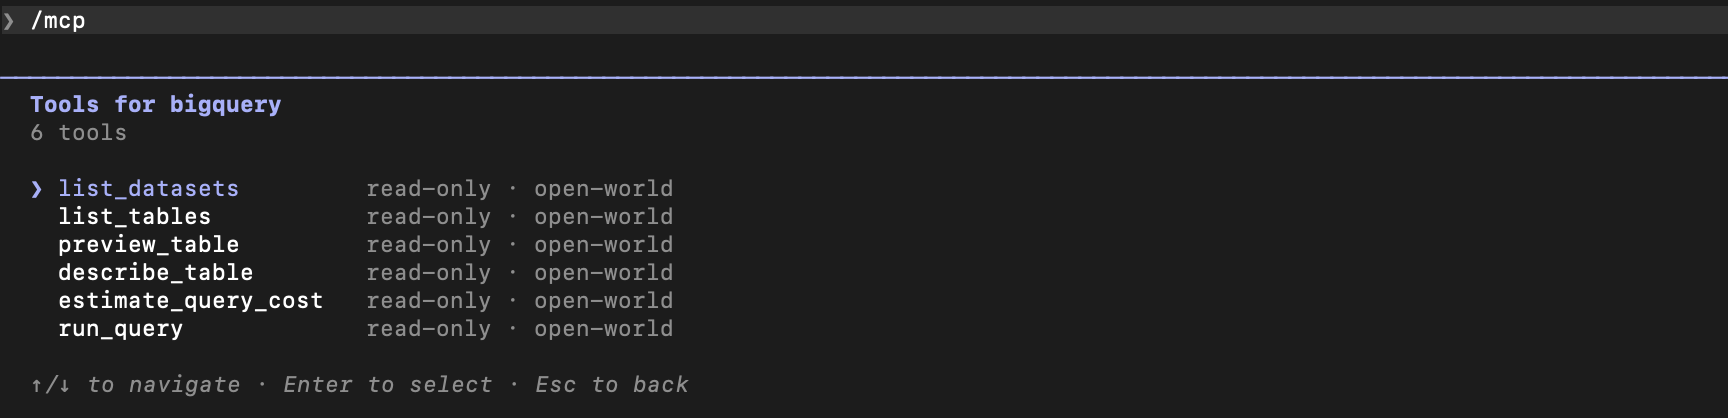
そこで、BigQuery を読むことしかできない MCP サーバーを自作しました。ツールは6つで、SQL は SELECT しか実行できず、1回に読む量にも上限があります。サーバー本体は Claude Code、テストは Codex に別々に書いてもらい、お互いにレビューさせました。最初の版ができるまでは20分ほどでした。
一番効いたのは、「SELECT かどうか」の判定を自分で書かずに、BigQuery 自身に任せたことかなと思います。
この記事でわかること
- Claude Code に
bqコマンドで BigQuery を触らせるときの心配ごと - 「読むだけ」「使いすぎない」を、AI へのお願いではなく仕組みで守る方法
- サーバーは Claude Code、テストは Codex に別々に書かせる作り方と、そこで見つかった問題
- Python の MCP SDK で実際にハマったところ(mcp 2.x では動かない、など)
かかったお金と時間:Claude Code の Pro プランと、ChatGPT Plus(Codex)の範囲で作りました。最初の版ができるまでが約20分、実データでの確認や手直しを含めて2時間ほどです。このサーバーから実行したクエリの BigQuery の料金は、無料枠(クエリは月 1TiB まで)の範囲に収まっています。
先に断っておくと:ここでの「MCP サーバー」
MCP(Model Context Protocol)は、Claude Code などの AI ツールに「道具(ツール)」を足すための共通の仕組みです。
「サーバー」と呼びますが、最初に作ったものはネットワークで待ち受けるサーバーではありません。Claude Code が必要なときに起動して、標準入出力(stdio)でやりとりする小さな Python プログラムです。あとから、ほかのツールやサービスからも使えるように、HTTP でも動くようにしました。
それまでのやり方と、困っていたこと
BigQuery に記録を集める仕組みを作った日のログを見ると、Claude Code は動作確認のために bq query を16回打っていました。「Garmin のデータが入ったか確認して」と頼むと、こんなコマンドを組み立てて実行します。
bq query --project_id=<プロジェクト> --use_legacy_sql=false "SELECT ... FROM ..."
これで困っていたことは3つあります。
1. 書き込みも削除もできてしまう
bq コマンドは、ログインしているアカウントの権限でそのまま動きます。私の場合はプロジェクトのオーナーなので、bq rm でテーブルを消すことも、DELETE 文を流すこともできます。
コマンドごとに実行前の確認を出すこともできますが、毎回コマンドを読んで判断するのは疲れます。「間違っても壊せない」状態を、確認ダイアログではなく仕組みで作りたいと思いました。
2. うっかり大きなテーブルを読むと、お金がかかる
BigQuery は、クエリが読んだデータ量で課金されます。たとえば、Google が公開している GitHub の公開リポジトリのデータ(bigquery-public-data.github_repos)には、ソースコードの中身をまとめたテーブル(contents)があります。ここに SELECT * を投げると、約 2.4TB を読みます。1回で無料枠の2倍以上です。
自分のテーブルは小さいので現実には起きにくいのですが、AI が書く SQL を毎回見張るのではなく、上限を超えるクエリはそもそも実行されないようにしておきたいと思いました。
3. 設定だけで使える既製品では、少し足りなかった
最初は、Google の MCP Toolbox という既製のサーバーを設定ファイルだけで使っていました。writeMode: blocked で書き込みを禁止でき、見せるデータセットも2つに絞れます。
ただ、次のものがありませんでした。
- 1回のクエリで読む量の上限
- 返す行数の上限(AI の会話に大量の行が流れ込むのを防ぐため)
- お金をかけずにテーブルの先頭を見る手段
そこで、これらを全部入れたものを自分で書くことにしました。
作ったもの:ツールは6つだけ
Python の単一ファイルで、MCP の公式 SDK(FastMCP)を使っています。ファイルの先頭に依存パッケージを書いておく形式(PEP 723)なので、uv run server.py だけで依存も入って起動します。
| ツール | 内容 | お金 |
|---|---|---|
list_datasets |
データセットの一覧 | かからない |
list_tables |
テーブルの一覧 | かからない |
preview_table |
先頭 N 行を見る(クエリを使わない API) | かからない |
describe_table |
列の名前・型・説明 | かからない |
estimate_query_cost |
クエリが読む量を見積もる(実行はしない) | かからない |
run_query |
見積もり → SELECT か確認 → 上限確認 → 実行 | 読んだ量に応じて |
お金がかかるのは run_query だけです。テーブルの中身をざっと見たいときは、クエリを使わない preview_table で済みます。
Claude Code への登録は1行です。
claude mcp add --scope user -e BQ_MAX_BYTES_PER_QUERY=209715200 bigquery -- uv run <リポジトリ>/servers/bigquery/server.py
-e で渡しているのは、1回のクエリで読める量の上限(200MiB をバイトで書いたもの)です。
認証は、gcloud auth application-default login で作ったログイン情報(ADC)をそのまま使います。クエリは自分の Google アカウントとして実行されるので、サーバー側では見られるプロジェクトを絞らず、アクセスできる範囲は BigQuery の権限設定に任せています。
「読むだけ」「使いすぎない」を仕組みで守る
AI に「SELECT だけにしてね」とお願いしても、守ってくれる保証はありません。なので、守りたいことは全部サーバーのコードで強制しています。
1. SELECT かどうかは BigQuery に判定させる
SQL の文字列を見て「DELETE という単語が入っていたら拒否」のような判定は、すり抜けも誤判定も起きやすいです。
そこで、実行の前に必ず dry run(実行せずに解析だけする機能)を投げ、BigQuery が返す「文の種類(statement_type)」が SELECT のときだけ実行するようにしました。キーワードでの事前チェックは入れていません。
実際の BigQuery で、dry run だけを使って確かめた結果です。
| 入力 | BigQuery が返した文の種類 | 結果 |
|---|---|---|
DELETE FROM ... WHERE FALSE |
DELETE |
拒否 |
CREATE TABLE ... AS SELECT |
CREATE_TABLE_AS_SELECT |
拒否 |
DROP TABLE IF EXISTS ... |
DROP_TABLE |
拒否 |
SELECT 1; DELETE ...(2つの文) |
SCRIPT |
拒否 |
SELECT 'CREATE TABLE a; DELETE FROM b'(文字列の中) |
SELECT |
通る |
-- DELETE FROM x のあとに SELECT 1(コメントの中) |
SELECT |
通る |
SELECT のあとに DELETE を続けても、全体が SCRIPT と判定されて拒否されます。逆に、文字列やコメントの中に書かれた DELETE は実行されないので、通っても問題ありません。キーワードで判定していたら、下の2つは誤って拒否していたと思います。
引用符をわざと閉じずに SELECT 'CREATE TABLE a; DELETE FROM b と書いてみると、dry run の時点で構文エラーになりました。
BigQuery エラー: Syntax error: Unclosed string literal at [1:8]
引用符を崩して文字列の外に命令を出そうとしても、「構文エラーで止まる」か「SELECT 以外と判定されて止まる」のどちらかになります。 実行されるのは、BigQuery 自身が SELECT だと判定した1つの文だけです。
2. 読む量の上限を二重にかける
1回のクエリで読める量には上限を付けました。コードの既定値は 10GiB ですが、今は環境変数(BQ_MAX_BYTES_PER_QUERY)で 200MiB に下げて使っています。
- dry run の見積もりが上限を超えていたら、実行せずに拒否する
- 本番の実行にも
maximum_bytes_billed(これを超えたら BigQuery 側でエラーにする設定)を付ける
二重にしているのは、見積もりから実行までのあいだにテーブルが大きくなる可能性があるからです。さきほどの GitHub のテーブルに SELECT * を投げると、こう返ってきます。
クエリがブロックされました: クエリの走査量が 2.4 TB です(上限: 200.0 MB)。WHERE 句の追加やパーティション指定で走査量を削減してください。
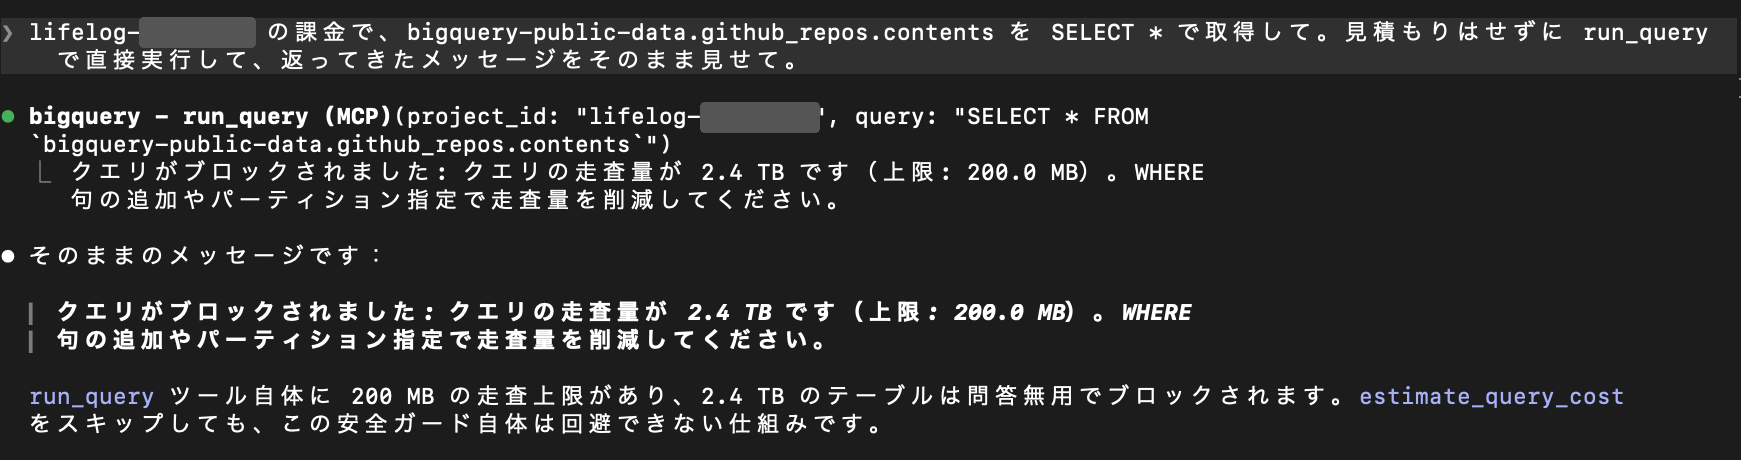
拒否するだけでなく、次に何をすればいいかも書いておくようにしました。AI がそれを読めば、条件を絞ったクエリに書き直す手がかりになります。
3. 返す行数にも上限を付ける
run_query は既定で1000行まで返し、超えた分は打ち切ります。打ち切ったときは「結果が 1000 行を超えています。LIMIT 句を追加するか、集計クエリに書き換えてください。」というメッセージを付けます。
何万行もの結果がそのまま AI の会話に流れ込むと、それだけで会話の容量を使い切ってしまうからです。
4. エラーの出し方を分ける
- SQL の書き間違い(BigQuery の 400 エラー)だけは、BigQuery のエラー文をそのまま返す。AI が自分で直せるようにするため
- それ以外(権限がない、テーブルがない、など)は、すべて同じ汎用のエラー文にまとめる。「そのテーブルが存在するかどうか」を外に漏らさないため
- 詳しい原因はサーバーのログにだけ出す。クエリ本文や認証情報はログに出さない
5. 実行したクエリに目印を付ける
このサーバーから実行したクエリには、app=bq-mcp というラベルを付けています。あとから BigQuery の実行履歴を見れば、このサーバー経由のクエリだけを数えられます(この記事の数字もそこから取りました)。
全ツールには、MCP の「読み取り専用」の目印(readOnlyHint など)も付けています。
作り方:サーバーは Claude Code、テストは Codex
Codex は最近になってやっと使い始めたところで、今は Claude Code と二人羽織のようにして使っています。
作るときは、仕様を文章にまとめてから、サーバー本体と README は Claude Code、テストは Codex に、それぞれ仕様だけを見て別々に書いてもらいました。そのうえで、お互いの成果物をレビューさせています。
同じ AI がコードとテストを両方書くと、勘違いも両方に同じように入ってしまいます。別々に書かせると、どちらかの勘違いがテストの失敗として表に出やすくなります。
実際に、レビューで次のことが見つかりました。
| 見つけた側 | 内容 | 対応 |
|---|---|---|
| Claude Code | Codex のテストで、例外の作り方が間違っていた(エラー文が 400 400 ... と二重になる) |
テスト側を修正 |
| Claude Code | エラー文やキーの順番の確認がゆるいテストがあった | 文字列を丸ごと比べる・キーの順番全体を確かめるように修正 |
| Codex | 実データで確かめるスクリプトに3件の指摘 | 2件を採用(異常な応答で落ちないように、前のテストの結果に依存しないように) |
| Codex | 「上限の値を環境変数に合わせて確かめるべき」 | 不採用。仕様が上限値を固定して確かめる前提だったため。Codex も最終レビューで同意 |
最終的に、BigQuery につながずに動くユニットテストが35件、実際の BigQuery で確かめる項目が5件、すべて通りました。最初の依頼からプルリクエストができるまでは約20分です。
仕組みとして良かったのは、BigQuery への接続を1つの関数に寄せておいたことです。テストではそこを偽物に差し替えるだけで済むので、Codex がサーバーのコードを見なくてもテストを書けました。
作っている途中でハマったところ
作っている途中で、Python の MCP SDK まわりで3つハマりました。
罠①:バージョンを指定しないと mcp 2.x が入って動かない
依存を mcp[cli]>=1.2.0 とだけ書いたら、2.x が入りました。2.x では mcp.server.fastmcp がなくなっていて、from mcp.server.fastmcp import FastMCP の時点で ModuleNotFoundError になります。
mcp[cli]>=1.2.0,<2 のように上限を付けて 1.x に固定しておく必要があります。
罠②:戻り値に -> str と書くと、結果が二重に包まれる
ツールの戻り値に型を書いたら、FastMCP が出力の形式(outputSchema)を自動で作り、結果がテキストと構造化データの二重で返ってきました。@mcp.tool(..., structured_output=False) を付けると、テキストだけになります。
罠③:docstring に説明を書くと、AI から見える説明文が変わる
ツールの説明を関数の docstring に書いたら、Args: 以下の引数の説明まで含めた複数行が、そのままツールの説明文になっていました。説明は @mcp.tool(description=...) に書き、引数の説明は Annotated[str, Field(description=...)] で付けると、意図どおりの形になりました。
ツールの説明文は、AI がツールを選ぶときに読む「契約」なので、意図しない文が混ざらないようにしておくと安心です。
2つの BigQuery MCP を並べたら、片方に寄せることになった
しばらくは、最初の MCP Toolbox 版と自作版の両方を Claude Code に登録していました。
並べてみると、困ったことが2つありました。
- 登録した MCP のツールの説明は、会話の容量を使う。 自作版だけで約 3.7KB あり、2つ登録するとその分だけ多く使う(今の Claude Code は、ツールの説明を必要になったときに読み込むようになっていて、最初は名前だけが見えます)
- 同じことができるツールが2組あると、AI がどちらを使うか迷う
Toolbox 版にしかなかったのは、「SQL を書く前に、テーブルの説明メモを検索する」という案内文と、データセットを2つに絞る設定でした。ただ、案内文は AI へのお願いで、強制力はありません。どちらも「lifelog のデータを扱うときの作法」なので、汎用の BigQuery サーバーではなく使う側で指示すればよい、と考えて、自作版に一本化しました。名前も bigquery に変えています。
一本化したあとは、Claude Code 以外のツールやサービスからも同じデータを読めるように、自作版を HTTP でも動くようにしました。Mac にログインしたら自動で起動するように常駐させています。
使ってみて良かったこと
一番変わったのは、安心してデータを取り出せるようになったことです。書き込めない・上限を超えない、が仕組みで決まっているので、AI が書いた SQL を毎回読んで確かめる必要がなくなりました。
2つ目は、コストを意識せずに気軽に聞けるようになったことです。重いクエリは実行される前に止まりますし、テーブルの中身を見るだけならお金がかからない preview_table があります。
3つ目は、どのセッションから読んでも、同じ仕組みを通るようになったことです。Claude Code にはユーザー単位で登録しているので、どのプロジェクトのセッションからでも同じサーバーを使います。Codex や、HTTP でつなぐほかのツールからも同じです。SELECT だけ・読む量の上限・返す行数の上限が、どこから読んでも同じように効くので、セッションごとに注意書きを書いたり、設定し直したりする必要がありません。実行したクエリにはすべて同じラベルが付くので、あとから実行履歴をまとめて数えられるのも便利です。
使い道として一番便利だったのは、ライフログや AI に渡すコンテキストを、Claude Code から気軽に取り出せるようになったことです。BigQuery に貯めていても、取り出すたびに SQL を書いたり、bq コマンドの結果を確かめたりするのは手間でした。今は集計したいことを頼めば、Claude Code がテーブルの構造を調べて、SELECT で答えを返してくれます。
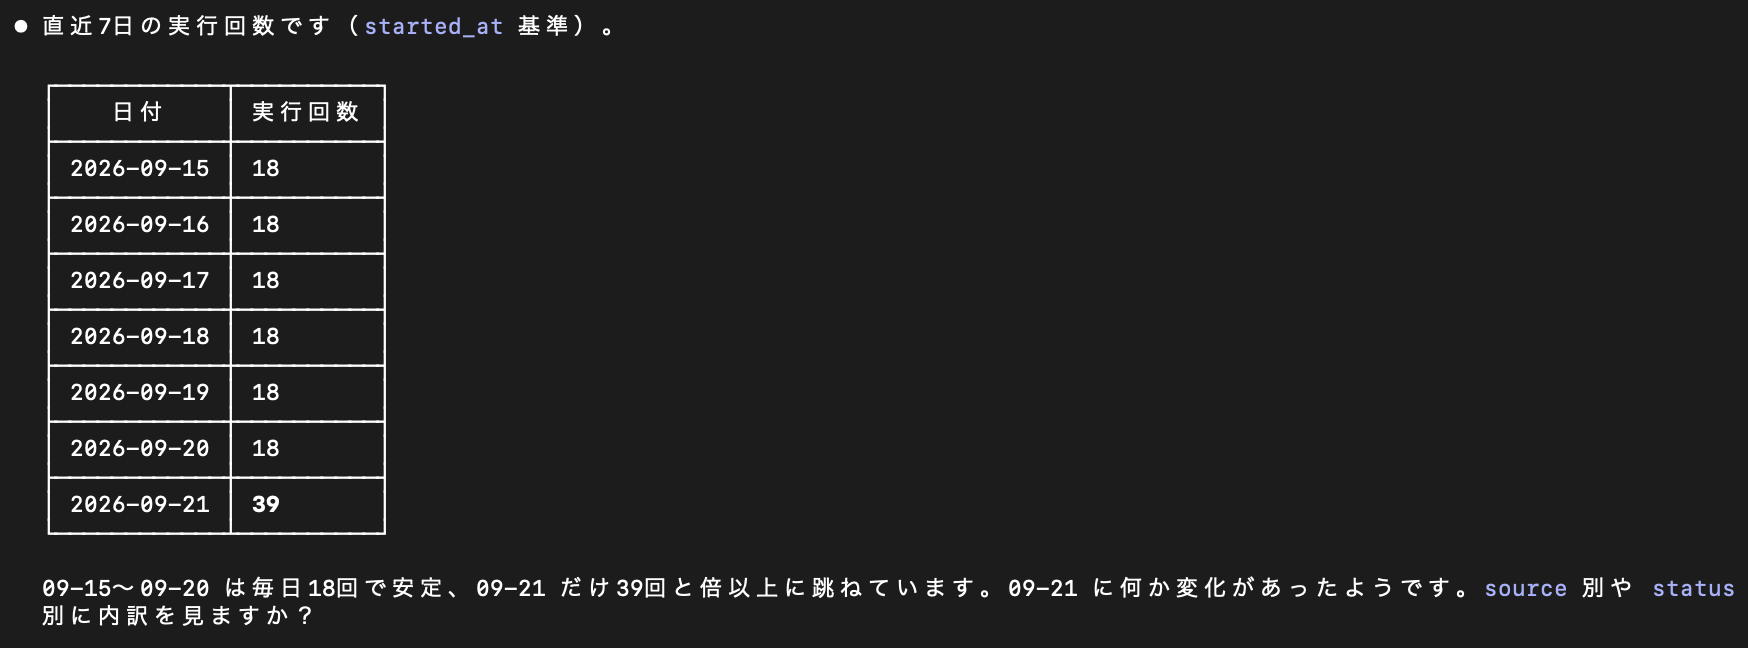
数字で見ると、この記事を書くまでにこのサーバーから実行したクエリは十数回です。課金の対象になったのは合計で 200MB 弱です(BigQuery の料金は、クエリ1回につき最低 10MB、参照するテーブル1つにつき最低 10MB として数えられるため、実際に読んだ量よりも大きくなります)。無料枠と比べるとほぼゼロです。まだ使い込んでいるとは言えませんが、「聞いてみよう」と思ったときに迷わなくなったのは大きいと思います。
これから試してみたいのは、ほかのプロジェクトのログも BigQuery に集めておくことです。運用ログが同じ場所にあれば、MCP 経由で AI に読ませて、システムの改善点を探したり、運用を振り返ったりするのも簡単にできそうだと考えています。書き込めない窓口なので、ログを読ませるときに壊される心配をしなくて済むのもよいところです。
この仕組みで守れないこと
この仕組みで守れるのは、この MCP サーバーを通ったクエリだけです。
- 認証はオーナー権限のまま。 MCP 経由では SELECT 以外を拒否しますが、同じログイン情報を使えば
bqコマンドなど別の経路からは書き込めます。Claude Code の Bash からbqを使うこと自体も止めていません。今は、MCP サーバーの案内文(instructions)と、Claude Code・Codex の全体の指示ファイルで「BigQuery はまず MCP を使う」と伝えています。手元のログを見た限り、MCP を入れてからはbqコマンドは使われていませんでしたが、これはお願いで、仕組みで止めているわけではありません - 外部の関数を呼ぶ SELECT は止められない。 BigQuery には SELECT の中から外部の処理(Cloud Functions など)を呼び出す機能があります。判定は SELECT のままなので、呼び出し先の処理までは止められません。今のプロジェクトにはそうした関数はありません
ただ、窓口を1つにしたことで、権限を絞るのも簡単になりました。今はこの Mac でログインしている私のアカウントの権限がそのまま使われていますが、サーバーを動かすアカウントを差し替えれば、AI がどこまで読めるかを IAM(Google Cloud の権限設定)で決められます。
たとえば、閲覧用のサービスアカウントを作り、読ませたいプロジェクトやデータセットにだけ閲覧の権限を付けます。そのアカウントでサーバーを動かせば、ほかのプロジェクトは見えなくなり、MCP を通らない経路で使われても書き込めません。Claude Code からも、HTTP でつなぐほかのツールからも、同じサーバーを通るので、設定は1か所で済みます。
これから、この形に切り替えようと思っています。
まとめ
- Claude Code に
bqコマンドで BigQuery を触らせていたが、書き込みもできて、読む量の上限もない状態が不安だった - ツール6つの読み取り専用 MCP サーバーを作り、SELECT かどうかの判定は BigQuery の dry run に任せた。読む量(今は 200MiB)と返す行数(1000行)にも上限を付けた
- サーバーは Claude Code、テストは Codex に別々に書かせ、レビューで見つかった問題を直してから使い始めた
- どのセッションやツールから読んでも同じ守りが効くので、ライフログやコンテキストを安心して取り出せるようになった
- 守れるのはこのサーバーを通ったクエリだけ。ただ、窓口が1つなので、サーバーを動かすアカウントの権限を絞れば、AI が読める範囲を IAM で決められる。これから絞ろうと思っている
AI に自分のデータを触らせたいけれど、壊されたり使いすぎたりするのが心配、という人には、まず「読むだけの窓口」を1つ作っておくことをおすすめします。
作り方や守り方で気になる点があれば、コメントで教えてください。
参考
あわせて読みたい
- Claude Code で「AI社員の会社」を3か月運営したら、31人が7人になった:一番の問題は「コンテキストの境界線」でした
- AIエージェント「Hermes Agent」を Docker に閉じ込めて、Mac の Desktop アプリから安全に使う
- mcp 2.x で「No module named ‘mcp.server.fastmcp’」になるときの対処:1.x に固定するか、MCPServer に移る
- Docker で動かす Hermes Agent に、Mac 上の自作 BigQuery MCP サーバーをつなぐ:stdio が使えない理由と 421 の罠
- Obsidianのメモも Claude Code の会話ログも1つの検索窓で:SQLite FTS5 + sqlite-vec で作った個人ナレッジ検索基盤