「あの時、何が起きてどう解決したんだっけ…」
Obsidian のメモ、Claude Code との会話ログ、作業の引き継ぎメモ。書いたものは確かにどこかにあるのに、探すときに場所がバラバラで毎回困っていました。Obsidian の検索は Obsidian の中だけ、Claude Code の過去セッションはそもそも検索しにくい。
そこで、手元のテキスト資産をまとめて検索できる個人用の基盤「second-brain」を作りました。
この記事でわかること
- SQLite 1ファイルで「全文検索+意味検索」のハイブリッド検索を作る方法
- 2つの検索結果を混ぜる RRF(Reciprocal Rank Fusion) の考え方
- 毎時の差分更新を安く・壊れにくく回すための工夫
- MCP サーバーにして Claude Code から直接呼べるようにした構成
なぜ自作したのか
既存のノートアプリや検索ツールでも、1つのソースの中なら十分探せます。困っていたのは次の3点でした。
- ソースをまたいで探せない:メモは Obsidian、起きたことと直し方は Claude Code の会話、手順は Markdown のリポジトリ…と分散している
- 言葉が一致しないと見つからない:「埋め込みのコスト」で探したいのに、メモには「ベクトル化の課金」と書いてある、というズレ
- AI から自分の過去の知識を参照させたい:Claude Code に作業させるとき、過去に決めたことを毎回説明し直すのが手間
最後の点が一番大きくて、普段使っている AI ツールから、自分のナレッジを直接検索できることをゴールにしました。
全体構成
設計の基本方針は ローカルファースト です。一次データ(メモや会話ログ)はローカルと Git に置き、検索インデックスもローカルの SQLite 1ファイルを正本にしています。
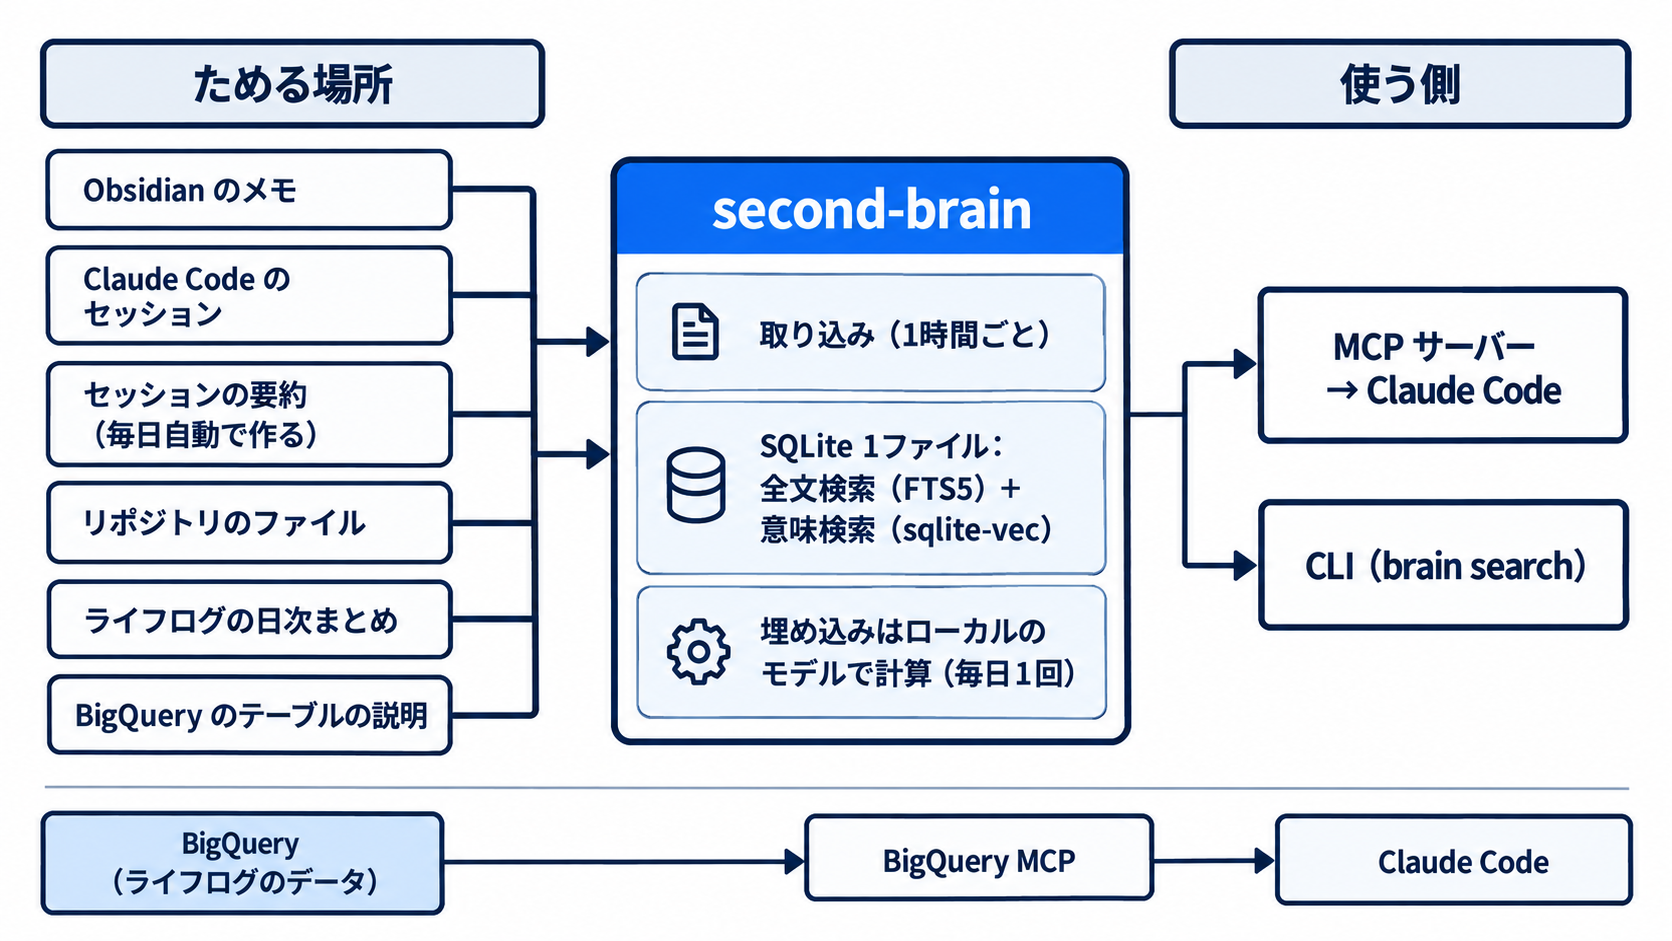
インデックス対象は config/sources.yaml に1つずつ書く形にしています。
sources:
  - name: vault
    kind: markdown
    path: "~/path/to/obsidian-vault"
    privacy: personal
  - name: sessions
    kind: claude-session-jsonl
    path: ~/path/to/session-history
    privacy: personal
リポジトリのファイルも取り込んでいますが、中に別の .git を持つフォルダ(他人のリポジトリのクローンなど)は、自分の知識ではないので読み飛ばしています。
AI がたどりやすい形式で書く:OKF
second-brain のリポジトリで管理しているナレッジ(BigQuery のテーブルの説明や、手順書など)と設計書は、OKF(Open Knowledge Format) という形式で書いています。Google Cloud が提案したオープンな仕様で、特定の AI サービス向けではなく、どの AI からも読める形を目指したものです。
決まりはシンプルで、次の3つが中心です。
- Markdown に YAML の frontmatter を付ける(仕様で必須なのは
typeだけ) - 文書どうしを、ふつうの Markdown のリンクでつなぐ
- 目次の
index.mdからたどれるようにし、変更の履歴はlog.mdに書く
second-brain では、frontmatter に id・type・title・status などを入れています。
---
id: voice-log-table
type: bq-table
title: 音声ログテーブルの意味定義
status: active
---
type は検索の絞り込みに使え(たとえば type=bq-table で BigQuery のテーブルの説明だけを探す)、status: deprecated の文書は検索の順位が下がります。どんな文書か、どこにつながっているかが frontmatter とリンクに書いてあるので、AI が必要なところまでたどりやすくなります。
なお、Obsidian のメモは、今のところふつうの Markdown のままです。frontmatter のないメモは note として扱われるので、OKF に書き直さなくても検索には乗ります。
コードの分け方:コアはライブラリ、外側は薄く
モノレポで、依存の向きを一方向に固定しています。
| 層 | 中身 | 持たないもの |
|---|---|---|
packages/brain-core |
取り込み・チャンク分割・索引・ハイブリッド検索 | HTTP サーバー、CLI の引数処理 |
packages/llm |
埋め込み・LLM 呼び出しの抽象(役割ごとに設定でモデルを切替) | ビジネスロジック |
apps/cli など |
brain-core を呼んで表示するだけ |
検索ロジック |
検索ロジックを1か所にまとめておくと、CLI・MCP・将来の API のどこから呼んでも同じ結果になります。モデル名もコードに書かず config/models.yaml に外出ししています。
検索の仕組み:全文検索とベクトル検索を混ぜる
2種類の検索を同じ SQLite に同居させる
- FTS5(trigram トークナイザ):単語の一致に強い全文検索。日本語は分かち書きが難しいので、3文字ずつ区切る trigram を使っています
- sqlite-vec:文章の「意味」の近さで探すベクトル検索。言い回しが違っても拾えます
どちらも SQLite の中で動くので、1ファイルに収まるのがポイントです。別途検索サーバーを立てる必要がないので、個人用途にはちょうどいい重さでした。
RRF で2つのランキングを1つにまとめる
全文検索とベクトル検索は、スコアの意味も大きさもまったく違います。そのまま足し算はできません。
そこで使っているのが RRF(Reciprocal Rank Fusion) です。考え方はシンプルで、スコアではなく「何位だったか」だけを使って合算します。
def rrf(rank_lists: list[list[str]], k: int = 60) -> dict[str, float]:
    """各ランキングでの順位から、1 / (k + 順位) を足し合わせる"""
    scores: dict[str, float] = {}
    for ranks in rank_lists:
        for rank, chunk_id in enumerate(ranks, start=1):
            scores[chunk_id] = scores.get(chunk_id, 0.0) + 1.0 / (k + rank)
    return scores

# 全文検索とベクトル検索、それぞれの結果(chunk_id の順位リスト)を渡す
fused = rrf([fts_ids, vec_ids])
両方の検索で上位に来たものほど高くなり、片方でしかヒットしないものも拾えます。
実際の実装では、このあと補正を3つかけてから上位を返しています。
- ソースごとの重み:セッションの要約は生の会話ログより少し上(1.15)、コードは少し下(0.8 まで)
- 古いものを少しずつ下げる:会話ログとその要約は半減期180日、日次のまとめは365日
- 使わなくなった文書を下げる:
deprecatedの付いた文書は半分
本当に効いたのか:回帰お題30問で測定
設計の段階で、「完成の定義」を固定の30問(質問と、ヒットすべき文書のセット)で測ると決めておきました。お題そのものは、検索の最初の版ができた翌日に作っています。上位8件に正解が入るか(hit@8)で測った結果がこちらです。
| 検索方式 | hit@8 |
|---|---|
| 全文検索(FTS5)のみ | 83% |
| ハイブリッド(FTS5 + ベクトル、RRF) | 97% |
全文検索だけでも8割は拾えていましたが、ハイブリッドにすると取りこぼしがほぼなくなりました。言い回しが違う質問に強くなったのが効いていると思います。
この数字は、埋め込みに Vertex AI のモデル(gemini-embedding-001)を使っていたときのものです。
最初は Vertex AI で埋め込みを計算していましたが、途中でローカルで動く日本語向けのモデル(ruri-v3-310m)に替えました。理由は単純で、Vertex AI だと料金がかかっていたからです。料金が気になって brain embed を気軽に回せず、新しく増えた分(約4.7万チャンク)がベクトル検索に乗っていない状態になっていました。
替える前に、同じ30問で比べています(比べやすいように、対象の文書を絞った条件です)。ハイブリッドでの正解は、Vertex AI が23問、ruri が22問でした。精度はあまり落ちなかったので、ruri に替えています。替えたあとの全体での測り直しは、まだしていません。
ポイントは、設定やモデルを変えるたびに同じ30問で比べられることです。「なんとなく良くなった気がする」ではなく、数字で判断できるようになりました。
インデックス更新:毎時回しても壊れない工夫
メモは毎日増えるので、インデックスは launchd で毎時 差分更新しています。
| 処理 | 実行タイミング |
|---|---|
brain index(差分更新) |
毎時+ログイン時 |
brain distill(会話セッションの要約を作成) |
毎日 4:30 |
brain embed(新しいチャンクのベクトル化) |
毎日 5:00 |
2段階のチェックで「読まなくていいファイル」を飛ばす
- 更新日時を見る:前回から更新日時が変わっていないファイルは読まない
- 中身のハッシュを見る:更新日時が変わっていても、中身が同じなら索引を作り直さない
さらに、チャンクの ID を「文書の ID +本文」のハッシュにしています。同じ内容を何度入れても同じ ID への上書きになるので、途中で失敗しても再実行すれば自然に正しい状態に戻ります(冪等)。
地味に大事だった「ハッシュは成功してから保存」
取り込みに失敗したファイルのハッシュを先に保存してしまうと、次回「変更なし」と判定されて永久に取り込まれなくなります。なので、ハッシュは、文書とチャンクの書き込みと同じトランザクションで保存しています。書き込みが失敗すればハッシュも残りません。こういう細かい順序が、放っておいても静かに壊れないかどうかを分けると感じています。
MCP サーバーにして Claude Code から呼べるようにする
検索コアを MCP サーバーでラップして、Claude Code に登録しています。ツールは読み取り専用の4つだけです。個人データを扱うので、検索結果に紛れた文章からの指示で何かが書き換わることがないように、書き込むツールは作っていません。
| ツール | 用途 |
|---|---|
search_knowledge |
ハイブリッド検索(ソース・リポジトリ・種類・更新日などで絞り込み可) |
read_note |
ヒットしたノートの全文を取得 |
list_recent_notes |
最近更新したノートの一覧 |
get_index_status |
インデックスの鮮度(最終ビルド時刻・件数)を確認 |
ツールの description が実質のルーター
どのツールをいつ呼ぶかは AI が判断するので、description に「いつ呼ぶか/いつ呼ばないか」まで書くのが大事でした。たとえば search_knowledge には、次のように書いています。
ユーザーの過去のメモ・設計判断・手順・作業履歴・会話に関する質問のとき呼ぶ。一般知識や Web 上の情報の質問では呼ばない。
同じ description には、BigQuery 上のライフログの集計や数値の質問は、このツールではなく BigQuery のツールを使うように、とも書いています。数字の質問は、読み取り専用の BigQuery MCP のほうに回すためです。
もう1つの注意点が readOnlyHint: true の明示です。MCP では、この値を書かないと「読み取り専用ではない」扱いになります。クライアントによっては、そのたびに承認を求めてくるので、読み取り専用のツールは明示しておくのがおすすめです。
トークンの節約になるのか、測ってみた
AI に過去のことを探させるとき、second-brain を通すと、AI の会話に入る量(トークン)がどれくらい変わるのかを測ってみました。
題材は、実際にあった4つの出来事です。「あの時どうしたっけ」と聞く形の文で second-brain を検索し、同じ出来事をセッションのログから grep で探した場合と比べました。grep は、キーワードを含む行をそのまま出す、いちばん素朴なやり方です。
| 出来事 | grep で出る行 | セッションのログ全体 | 会話の部分だけ | 検索1回(上位8件) | 要約1本 |
|---|---|---|---|---|---|
| Hermes から MCP につなぐと 421 | 38KB | 1,360KB | 68KB | 4.3KB | 2.6KB |
| GitHub Actions の容量超過で二重投稿 | 24KB | 219KB | 12KB | 4.4KB | 2.1KB |
| ComfyUI でカーネルパニック | 131KB | 5,475KB | 130KB | 4.1KB | 2.2KB |
| Plaud の Cookie がすぐ切れる | 649KB | 1,403KB | 15KB | 3.7KB | 2.4KB |
「会話の部分だけ」は、ログからツールの出力などを除いた、人と AI のやり取りの文章です(read_note で1本読んだときの量)。
検索1回は4KB前後で、素朴な grep の約5〜175分の1でした。 セッションのログは1行に1メッセージ分が丸ごと入っていて、ツールの出力も含まれるので、grep で1語を探すだけでも、ヒットした行が長くなります。
検索の精度も見ました。すべてのソースから探すと、4件とも目当てのセッションが上位4位以内(1位・2位・4位・4位)に入りました。要約だけに絞って探すと、4件のうち3件で、目当ての要約が2位に入りました。
一番効くのは、セッションの要約
要約は1本2〜3KBで、会話の部分(12〜130KB)の約6〜60分の1です。全体で見ても、セッションのログが約800MBなのに対して、要約は1,179本で約5.4MBです。「あの時何が起きて、どう解決したか」を知りたいだけなら、要約を1本読めば済むことが多く、ここが一番効いています。ランキングで要約を生のログより少し上にしているのも、このためです。
効かないところ
- 要約から話題が落ちることがある:要約は1セッションにつき1本で、長さにも上限があります。1つのセッションでいくつもの話題を扱うと、どれを残すかは LLM 任せになり、残らない話題が出てきます。要約だけに絞って探して見つからなかった1件も、話題がいくつもあるセッションでした。なお、会話が6万文字を超えると先頭の6万文字しか読みませんが、そういうセッションは全1,203本のうち14本(1%)でした
- 抜粋だけでは足りないことがある:検索結果の抜粋は短いので、詳しく知るには
read_noteで会話を読む必要があります。そうすると12〜130KBになり、節約の幅は小さくなります - 関係ないものも返ってくる:同じ出来事を書いたブログの下書きや、clone してある OSS のドキュメントが上位に入ることがあります。上位8件のうち、目当てのセッションは1〜5件でした
- エラー文が分かっているなら grep も安い:正確な文字列が分かっているなら、
grep -lでファイル名だけを出して、そのセッションの要約を読むのが一番安く済みます。second-brain が効くのは、言い回しがあいまいなときや、どこに書いたか分からないときです - ツールの説明の分は毎回かかる:MCP のツール4つの説明は合わせて約4.2KBで、検索1回分くらいあります。ただ、クライアントによっては、使うまでツールの説明を読み込まない形になっていることもあるので、ここはクライアントしだいです
使ってみて
作ってみて思ったのは、情報をためる場所(入り口)はどうしてもいくつも必要で、そのうえで、それを取りまとめるものが必要だということです。Obsidian のメモ、AI とのセッション、リポジトリ、ライフログ……と、ためる場所はそれぞれの都合で増えていきます。second-brain は、その取りまとめ役です。
ローカルに置いているのは、クラウドにはあまり上げたくない情報が多いからです。
今は、Claude Code のセッションとその要約、各リポジトリのファイル、ライフログの日次のまとめ、Obsidian のメモなどを、SQLite の全文検索と sqlite-vec の意味検索でまとめて探せます。BigQuery に入れているライフログのデータそのものは、別の BigQuery MCP で取り、second-brain には「どのテーブルに何が入っているか」の説明を入れています。
これらをバラバラに取りに行くのは大変なので、1か所から取り出せるようになって、とても助かっています。AI とやり取りした内容も、ライフログも、普段のプライベートのことも、同じ仕組みを通して探せるようになりました。
注意点
- ベクトル化は1日1回なので、当日追加したメモは翌朝まで全文検索でしかヒットしません
- セッションの要約は、Vertex AI の Gemini 2.5 Flash-Lite で作っています。最初に作ったときにこれにして、そこまで高くないので、そのまま使っています。要約の出来にも、今のところ困っていません。モデル名は
config/models.yamlに書いているので、Vertex AI のほかのモデルにはすぐ替えられます。ただ、要約を作るときは会話の中身を API に送っています。セッションに機密情報が入っていて、それをクラウドの LLM に読ませたくない場合は、ローカルの LLM を使うしかないかなと思います(今の作りは、要約用のローカル LLM にはまだ対応していません) - MCP サーバーは stdio 方式なので、Docker の中で動かしている Hermes Agent からはまだ使えません(BigQuery MCP を Hermes につないだ記事と同じく、HTTP にする必要があります)
ruri に切り替えたことで、埋め込みの課金がなくなり、毎日自動で回せるようになりました。検索のときのクエリの埋め込みも、約520ms から 22ms と約24倍速くなっています。切り替えの詳しい話は、別の記事で書いてみようと思っています。
まとめ
- SQLite 1ファイルに FTS5 と sqlite-vec を同居させれば、個人用のハイブリッド検索は十分作れる
- 2つの検索結果は RRF で「順位だけ」を使って混ぜると扱いやすい
- 固定の回帰お題を先に作っておくと、改善を数字で判断できる(hit@8:83% → 97%)
- MCP にすると、普段の AI ツールから自分のナレッジをそのまま検索できる
「メモは書いているのに活かせていない」と感じている人は、まず全文検索だけでも1か所にまとめてみると、探す手間がかなり減ると思います。
あわせて読みたい