個人で、いくつかの小さな事業(ブログ・note・アフィリエイトなど)を並行して回したい。でも、自分1人では手が回らない……。
そこで、Claude Code のサブエージェントに役割を割り当てて「AI社員の会社」を作り、定期ジョブなどをきっかけに動かしてみました。社名は「Poco Tech」です。
あれから3か月。コミットは1,140、起票したタスクは100件を超えました。そして社員は、一時は8チーム31人まで増えたのに、今は7人です。
正直に言うと、思い描いていたようにはいきませんでした。
いろいろな失敗をしましたが、振り返ってみると、一番の原因はAI社員1人が扱うコンテキストの境界線を、うまく引けなかったことかなと思います。
この記事でわかること
- Claude Code で作った「AI社員の会社」の仕組み
- 31人の組織が7人になった理由
- 一番の問題だった「コンテキストの境界線」と、そこから芋づる式に起きたこと
- それでも良かったこと、次に試したいと思っていること
かかったお金と時間:Claude Code の Pro プラン(月額およそ22ドル。1ドル158円換算で約3,500円)の範囲で動かしています。時間は、仕組みづくりと手直しに、この3か月の空き時間のかなりの部分を使いました。
先に断っておくと:私のAI社員は「勝手に動く社員」ではない
「AI社員」と一口に言っても、人によっていろいろな解釈があると思います。
私の作った AI社員は、本物の社員(人間)のように、自分から考えて勝手に仕事を始めるものではありません。必ず何かのきっかけ(トリガー)があって、はじめて動く仕組みです。
私が使っていたトリガーは、こんなものです。
- 時刻(cron 的な定期実行):Mac の launchd で、毎朝7時の朝礼、毎晩2時の夜間シフト、30分ごとの指示の取り込みなどを起動する
- メール:メールを定期的にチェックして、特定のメールが届いていたら、それをきっかけに処理を動かす
- GitHub Actions の定期実行:家の PC で動いているシステムが生きているか(ちゃんと動いて、ネットにつながっているか)を、外から1日2回チェックする。これとは別に、GitHub 側の定期実行をきっかけに処理を動かすこともしていた
つまり、「社員」と呼んではいますが、実態はトリガーで起動する AI の処理の集まりです。社員が自分でタスクを見つけて自律的に進めていく、というものではありませんでした。
仕組み:AI社員は「定期ジョブで起動するサブエージェント」
| 要素 | 中身 |
|---|---|
| 社員 | Claude Code のサブエージェント。リポジトリ直下の .claude/agents/ に、1人1ファイルで役割・やってよいこと・禁止事項を書く |
| 就業規則 | 全員が最初に読むルール(CLAUDE.md)。「専門外の仕事は拾わない」「社長への報告は秘書を通す」「迷ったら止まる」など。判断は3段階に分け、お金・公開・戻せない操作は人間だけが決める |
| タスク台帳 | 1タスク=1つの Markdown ファイル。フォルダを「未着手 → 作業中 → 完了」と移すことで状態を表す(移した人が担当になるので、取り合いにならない)。ファイルには目的・完了条件・期限・失敗回数を書く |
| 引き継ぎ・記憶 | 会話での引き継ぎは禁止で、すべて書いて残す。タスクごとの申し送り、チームの日報、本人専用のメモの3種類 |
| 出勤 | Mac の launchd が決まった時刻に claude -p で社員を起動する。朝7時に朝礼、夜2時に夜間シフト、30分ごとに社長の指示の確認。時刻が来なければ誰も動かない |
| 社長の指示 | 2つの窓口がある。外出先からは GitHub の Issue(スマホからでも出せる)、家ではターミナルの Claude Code から直接指示する。PR のマージが公開の承認 |
社長(私)がやることは、指示を出すことと、決裁することだけ……のはずでした。
社員の様子は、ドット絵のオフィスで見られるようにしました。なくても困らないのですが、何か見えるものがあったほうがテンションが上がるので、作ってみました。
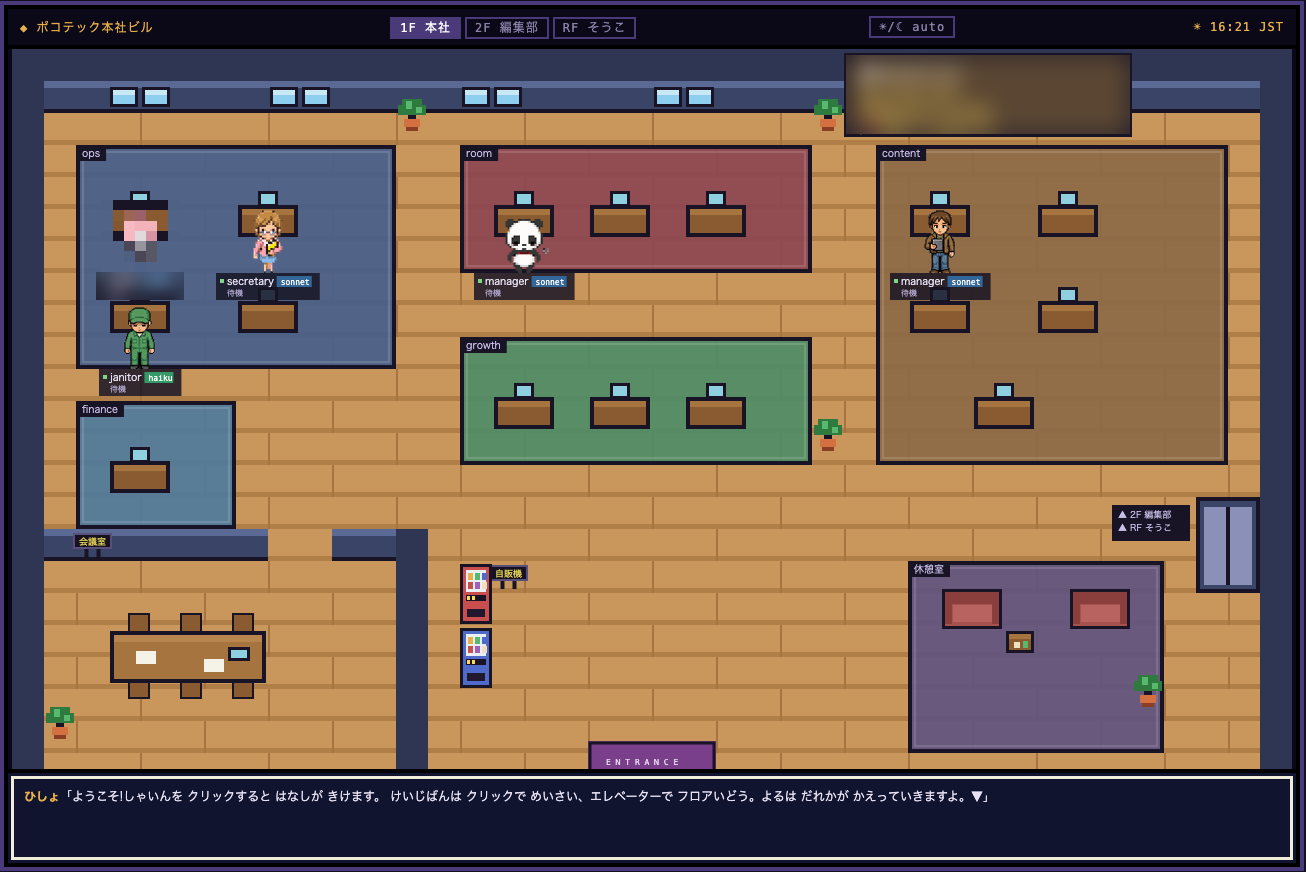
創業から3か月後のオフィスです。新規事業リサーチ(growth)と経理(finance)の部屋は、もう誰もいません。
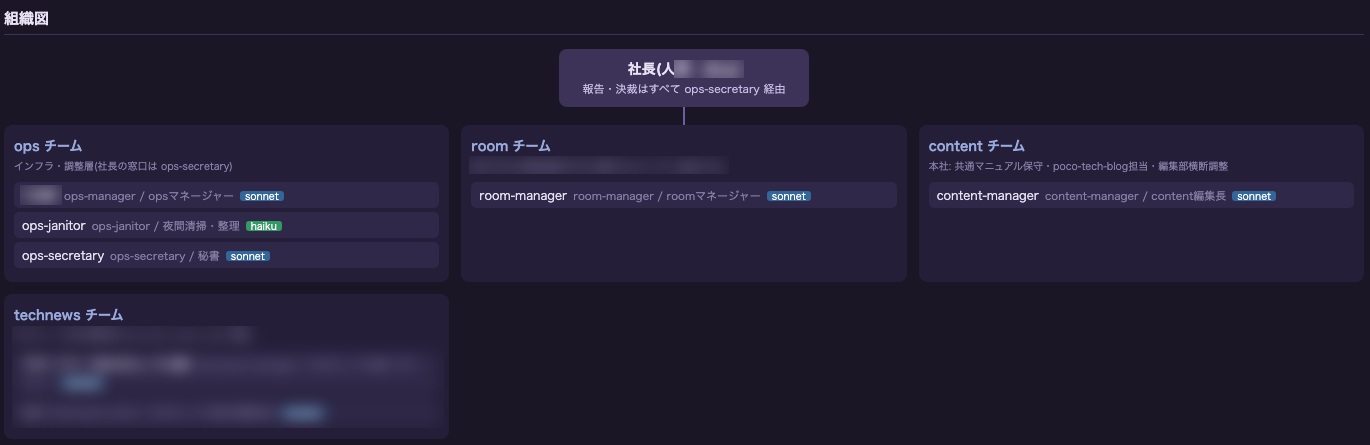
31人が7人になるまで
| 時期 | できごと |
|---|---|
| 創業時 | 2チーム8人 |
| 10日ほど後 | note 編集部3チーム、楽天ROOM チーム、新規事業リサーチなどを追加。8チーム31人に |
| 約3週間後 | 外部からの死活監視を導入(後述) |
| 約1か月半後 | 新規事業リサーチのチームが止まる。気づいたのは数日後 |
| 約2か月後 | 31人 → 9人に縮小 |
| 約2か月半後 | 9人 → 7人。note の2事業を休止 |
31人から9人に縮小したときは、実行ログ320本とタスクの担当者を数えて判断しました。
- 31人のうち22人が、起動実績ゼロか月1回未満だった
- 起動実績ゼロの社員は15人。定義ファイルがあるだけで、一度も働いていなかった
- ログに出てくる回数の1位と2位は、夜間の掃除係とマネージャー。つまり会社の「自己管理」をしている社員だった
組織図の上ではにぎやかでも、実際に働いていたのは一部だけ。そして、組織を維持するだけで、週の利用枠(トークンの上限)に達していました。この実態を調べたときは驚きました。
一番の問題:コンテキストの境界線を引けなかった
いろいろな失敗を並べてみると、多くはコンテキストの問題につながっていました。AI社員1人が「何を知っていればいいか」「どこまで見ればいいか」の境界線を、うまく引けていなかったのだと思います。
もちろん、境界線を何も決めていなかったわけではありません。社員ごとの定義ファイルには「責務」「やってよいこと」「禁止事項」を書き、記憶も自分専用にしていました。さらに Claude Code の hooks で、戻せない操作は機械的に拒否し、ツールを呼ぶ回数にも上限を設けていました。
ただ、hooks で止められるのは「何をするか」「何回するか」までです。「どこまで読むか」「何を見るか」は、ルールに書いておくだけで、実際は AI の判断任せでした。回数の上限は、使いすぎを止めてはくれても、見る範囲までは狭めてくれません。私が Claude Code で作業しようとしたら、AI社員が先に利用枠(トークン)を使い切っていて、何もできなかったこともありました。
1. コンテキストが大きくなって、仕事の前に力尽きる
わかりやすかったのが、ある日の朝礼です。
秘書役の社員が朝礼レポートを作る途中で、ツールを呼べる上限(57回)に達して止まり、その日のレポートが出ませんでした。中身を見ると、ファイルを読むのに38回、コマンドに16回を使っていて、レポートを書けたのは1回だけでした。
材料を集めるだけで力尽きていました。
| 使ったツール | 回数 |
|---|---|
| ファイルを読む(Read) | 38回 |
| コマンド(Bash) | 16回 |
| レポートを書く(Write) | 1回 |
直したのは2つです。朝礼に使う材料を1つのスクリプトにまとめて、1回の実行で集めるようにしたこと。そして、「残りの回数が少なくなったら、情報が薄くても先にレポートを書き切る」というルールを、秘書役の定義に足したことです。
読む範囲を AI社員の判断に任せず、仕組みの側で先に決めてしまう。今思えば、これが「境界線を引く」の一番小さな例でした。
2. 関係のない指摘や、間違った判断が増える
見る範囲が広いと、関係のないものまで拾ってしまいます。
- 日報が新しいかをチェックする掃除係が、同じ形の誤検知を何度も繰り返した(その修正だけでタスクが4件)
- 夜間に自動でタスクを進める仕組みが、「人間しか進められないタスク」まで拾ってしまった
- 夜間ジョブでは、4つの役割が1つの共通の指示文を使い回していた。役割ごとの境界線が、仕組みの側でも引けていなかった
警告が多いと、結局は人間が全部確かめることになります。
3. ログが増えて、次に探すコストが上がる
社員の記憶は、チームごとの日報(引き継ぎファイル)に書き足していく形にしていました。これが膨らみ続けて、運用チームの日報は1ファイルで約690KBになっています。
毎晩これを読ませれば、コンテキストはさらに大きくなります。ログが増えるほど、次に探すときのコストが上がる。悪循環です。
4. 人間の判断が必要な箇所が多すぎる
コンテキストの境界線が曖昧だと、変更の影響範囲も読めなくなります。だから、全部を AI に任せることができません。AI に自由に暴れてもらう、ということができませんでした。
実際、仕組みの変更は PR 経由、ガードレール(改札)の変更は人間だけ、というルールにしていました。安全のためには正しいのですが、そのぶん人間を通らないと進まない箇所が増えます。
- ダッシュボードを毎晩作り直すスクリプトが7晩続けて失敗していて、原因も修正もわかっていたのに、AI側の権限では PR まで進められず、誰も完了できなかった
- 人間だけが決められる事項(決裁)が広すぎて、朝礼の「要決裁」が最大9件まで溜まった。月4ドルの出費でさえ保留になっていた
このあと、人間だけが決める範囲を4つ(お金の執行、外部への公開、戻せない操作、ガードレール自身の変更)に絞って、だいぶ楽にはなりました。それでも、「仕組みの中心部分を直すには、人間の判断が要る」という構造は変わりませんでした。
5. PC の中を直接いじるので、便利だけど危ない
AI社員は、私の iMac の上で直接動いています。ファイルもコマンドも触れるので、何でもできて便利です。でも裏を返せば、何でもできてしまうということでもあります。
force push や再帰的な削除など、戻せない操作は「改札」で機械的に止めていました。それでも、作業場所が自分の PC そのものなので、ずっと少し怖さがありました。
落ちない、黙って止まる
これはコンテキストとは別の問題ですが、AI社員の会社の事故は、ほとんどがエラーで派手に落ちるのではなく、黙って止まる形でした。
- 創業2日目:launchd から起動したとき PATH に
claudeが入っておらず、夜間シフトは創業から一度も動いていなかった。朝礼だけは手動で成功していたので気づかなかった - 創業6日目:4つのチームが定期ジョブに一度も登録されていなかった。組織図の上では稼働中なのに、誰も起動していない
- 失敗ログが19日間静か:朝礼では「新しい失敗なし」が健全性の証拠として報告され続けたが、実は失敗を記録する仕組みごと止まっていた
- 約1か月半後:新規事業リサーチのジョブが止まり、気づいたのは数日後
創業2日目の事故は、社員を起動するスクリプトで PATH をはっきり指定して直しました。launchd の PATH には ~/.local/bin が含まれないので、export PATH="$HOME/.local/bin:/opt/homebrew/bin:/usr/local/bin:$PATH" の1行を足しています。あわせて、claude が見つからないときは通知して止まるようにしました。
こうした事故から得た結論は、監視を、動かしている仕組み(実行系)の外に出すことです。創業から3週間ほどたった頃から、GitHub Actions で1日2回、外から死活監視しています。push が26時間以上ない、日報が48時間以上ない、当日の朝礼がない、といった状態になるとメールが届きます。
「エラーが出ていない」は「動いている」ではない。3か月で一番身にしみたことです。
止まったあと、どこまで進んでいたかを追いにくい
もう1つ不便だったのが、1つのタスクの流れを、1本の線として追えなかったことです。
ログ自体はありました。タスクのファイルには申し送りを書き、社員ごとの日報にも作業の記録が残り、実行ログも別に保存していました。ただ、記録が社員ごと・場所ごとに散らばっていたので、どこかで処理が止まったときに「どこまで進んでいたのか」を後から見返すのが大変でした。
マネージャー役の社員は把握していたはずなので、それを分かりやすい形で出せていなかっただけかもしれません。それでも、ログを後から追うのは難しかったです。
それでも良かったこと
- note で、自分用のニュースブログを3か月弱で96本公開できた:仕事で扱っている技術(AI や GCP・AWS まわり)のニュースを自分のために集めたくて、AI社員の会社を作ってすぐに始めました。週に1回、AI社員がネタを集めて1週間分の記事を書き、毎日決まった時間に自動で公開しています。AI が書いた内容をそのまま世に出すのはやっぱり心配なので、最後の砦として人間が中身をチェックしてから公開する、という形にしていました。そのぶん情報は1〜2週間遅れますし、PV も週60ほどで、他の人の役に立っているかは分かりません。それでも、通勤中に note を開けば欲しい情報がまとまっている状態は、自分1人ではとても続けられなかったと思います
- スマホから Issue を書けば、家の PC の AI社員が作業を進めてくれる:やってほしい作業を GitHub の Issue に書いておくと、家の PC の AI社員がそれを見つけて、書いた内容のとおりに作業を進めてくれます。思いついたときにスマホから頼めるのは便利でした
- 外にいても、家の PC に安全に指示を出せる:本業の会社で働いている間も、スマホから家の PC の AI社員に指示を出せます。仕組みは、家の PC が30分ごとに GitHub の Issue を見に行くだけ(ポーリング)。外から家の PC へ直接つなぐ入口を開けずに済むので、安全で便利でした
- 毎朝の朝礼メールで、全体の状況がわかる:毎朝7時に、決裁が必要なこと、止まっていること、昨夜終わったことをまとめたメールが届きます。自分で見て回らなくても、全体の進み具合がわかるのは助かりました
- ガードレールの考え方が身についた:事前に止めるのは戻せない操作だけ。戻せるものは、Git の履歴と毎晩のバックアップで守る。この「戻せるかどうかで決める」という考え方は、ほかの自動化でもそのまま使えています
今も7人の社員が、毎朝の朝礼、note のニュース記事、楽天ROOM の運用を回しています。ただ、トリガーで決まった仕事をこなす以外に、新しく生まれる仕事は少なくなりました。
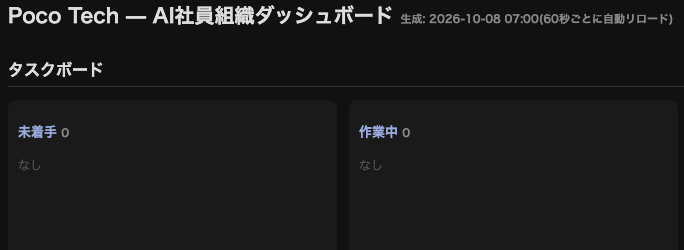
今朝のタスクボードです。未着手も作業中も0件でした。
正直な反省:設定とテストを詰めきれなかった
各エージェントの設定を、うまく作り込めていなかったのは確かです。そこにもっと時間をかけていれば、今より良い結果になったかもしれない、という気持ちは正直あります。
もう1つの反省は、テストをあまり書いていなかったことです。テストがあったのは改札(hooks)だけで、ジョブを動かすスクリプト側にはほとんどありませんでした。創業2日目の「夜間シフトが一度も動いていなかった」事故も、launchd と同じ環境で1回動かしてみるテストがあれば、すぐに気づけたはずです。
YouTube を見ていると、AI社員の仕組みをうまく回している人もいます。だから「AI社員はダメだ」と言いたいわけではありません。
ただ、3か月やってみて、向いている使い方と、向いていない使い方がはっきりした、というのが実感です。note のニュースブログのように、やることが決まっていて、最後に自分がチェックできる仕事を毎日回すのには向いていました。一方で、社員を増やして広い範囲を任せるやり方は、少なくとも今の自分の作り方ではうまく回せませんでした。
ちなみに、社員が多かった頃はトークン(利用枠)が尽きることがよくありました。今はそこまで困っていないので、お金や利用枠は一番の問題ではなかったと思っています。やはり、コンテキストにまつわる部分の影響が大きかったです。
もう一度やるなら、最初に決めておくこと
- 社員を増やす前に、1人が読む範囲と回数を決める
- 読む材料は、AI社員に探させず、仕組みの側で先に集めて渡す
- 日報や記憶には、残す期限を決める
- 監視は、動かしている仕組みの外に置く
- 事前に止めるのは、戻せない操作だけにする
- 定期ジョブは、launchd と同じ環境で一度動かして確かめる
次に試したいと思っていること:Hermes Agent でコンテキストを絞る
そこで今、オープンソースの AI エージェント「Hermes Agent」を試し始めています。ドキュメントを読む限り、今回つまずいた「コンテキストの境界線」は、ルールではなく仕組みの側で引けそうです。
| 今回困ったこと | Hermes Agent で変えられそうなこと |
|---|---|
| 1人が見る範囲(コンテキスト)を、ルールに書くことしかできなかった | 仕事を任せる先のエージェントは、それぞれ別のコンテキストで動く。使えるツールやつなぐ MCP サーバーも、エージェントごとに設定で絞れる |
| 日報が膨らみ続けた | 記憶の量に上限があり、過去のやりとりは必要なときに検索する形になっている |
| PC を直接いじるのが怖かった | コマンドを Docker の中で動かせる |
| 改札(hooks)を自作していた | 危ないコマンドの承認や禁止リストが、最初から用意されている |
一方で、「黙って止まる」問題は移しても残るので、外からの死活監視はそのまま続けるつもりです。また、Hermes は呼び出しのたびに読み込む決まった分が大きい、という指摘もあります。利用枠の減り方は、試しながら確かめたいところです。
もちろん、限界もあります。
- 守れるのは自分のローカル環境だけ。自分のサービスではないところ(外部のサービスの中)までは防ぎようがない
- Hermes の頭脳(LLM)は、今のところ Codex(ChatGPT のサブスク)しか使えていない。ローカル LLM も試したいけれど、まだ遅くて実用的ではない
まとめ
- Claude Code のサブエージェント+タスク台帳+定期ジョブで、AI社員の会社は作れる
- でも、AI社員を増やしても仕事は増えなかった。31人中22人は、ほぼ一度も働いていなかった
- 一番の問題は、AI社員1人が扱うコンテキストの境界線を引けなかったこと。そこから、力尽き・誤検知・ログの肥大化・人間の判断待ちが芋づる式に起きた
- 事故は黙って止まる。監視は実行系の外に出すことにした
- ガードレールは「戻せるかどうか」で決めるようにした
AI社員の仕組みを作ろうとしている人は、社員を増やす前に、1人ひとりが見る範囲(コンテキストの境界線)を先に決めることをおすすめします。私は、それに気づくまでに3か月かかりました。
同じように AI エージェントを組織的に動かしている人がいたら、うまくいっている方法をぜひ教えてください。
Hermes Agent を試してみて分かったことがあれば、また書いてみようと思います。