Claude Code を claude -p(非対話モード)で定期実行して、記事の下書き作りや朝のレポート作成などを自動化しています。AI に役割を割り当てた「AI 社員」が、launchd から毎日起動される形です。
便利なのですが、困ったことが起きました。自分が対話で使う分のトークンが足りなくなってきました。 サブスクの利用枠は、定期実行と対話で共有しています。
ところが、どのジョブがどれだけ使っているのか、まったくわかりませんでした。 そこで、ジョブごとのトークン消費を記録する仕組みを入れました。
この記事でわかること
claude -p --output-format jsonで、1回の実行ごとのトークン数とコストを取る方法- ジョブ別の消費を JSONL に記録する小さなスクリプト
- 計測してわかったことと、見直したこと
--allowedToolsの思わぬ落とし穴
まず止めた:成果が直接見えないジョブ
計測の仕組みを作る前に、応急処置として1つのジョブを止めました。新しい事業のアイデアを毎日リサーチする「growth」ジョブです。
- 他のジョブとの連携がない
- 成果物がすぐに役立つものではない
という理由で、優先度が低いと判断しました。
止めたあとは、少なくとも利用枠の上限に達することはなくなりました。余裕があるとまでは言えませんが、AI 社員だけで枠を使い切ることはなくなり、人が使う分は残るようになりました。
ただ、これは勘での判断です。ほかのジョブを見直すにも、何がどれだけ使っているのかを知る必要がありました。
--output-format json で使用量を取る
claude -p には --output-format json というオプションがあります。これを付けると、実行の最後にトークン数やコストを含む結果が JSON で出力されます。
claude -p "$PROMPT" \
  --permission-mode acceptEdits --model sonnet --effort medium \
  --output-format json \
  --allowedTools "WebSearch,WebFetch,Bash(bash scripts/deliver_draft.sh:*)"
出力はイベントの配列で、最後の type: "result" のイベントに使用量が入っています。
| 項目 | 内容 |
|---|---|
usage.input_tokens / output_tokens |
入力・出力のトークン数 |
usage.cache_read_input_tokens |
キャッシュから読んだトークン数 |
usage.cache_creation_input_tokens |
キャッシュに書いたトークン数 |
total_cost_usd |
API 料金に換算したコスト(参考値) |
duration_ms / num_turns |
実行時間とターン数 |
サブスクで動かしている場合、total_cost_usd は実際の請求額ではありません。ただ、ジョブ同士を比べる物差しとしては十分使えます。
ジョブごとに JSONL へ記録する
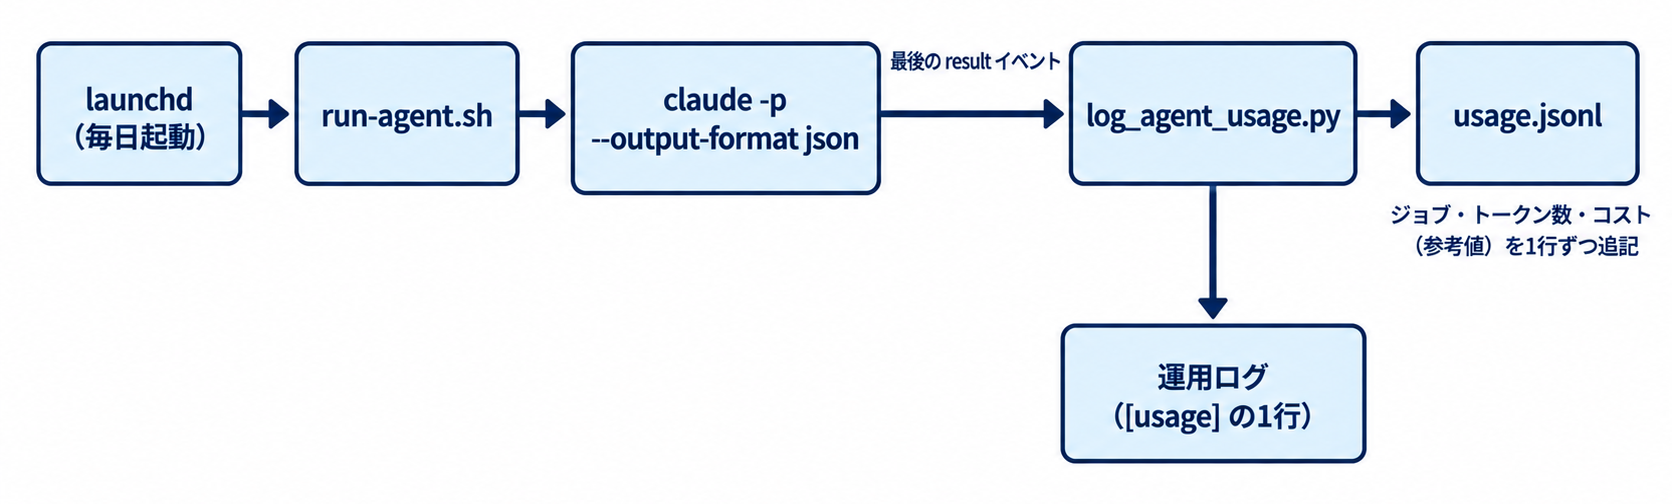
実行用のシェルスクリプト(run-agent.sh)で claude -p の出力をファイルに保存し、それを小さな Python スクリプトに渡して記録しています。
result = next((e for e in reversed(events) if e.get("type") == "result"), None)
usage = result.get("usage", {})
record = {
    "ts": datetime.now(timezone.utc).isoformat(timespec="seconds"),
    "job": job,
    "role": role,
    "attempt": int(attempt),
    "is_error": result.get("is_error"),
    "cost_usd": result.get("total_cost_usd"),
    "input_tokens": usage.get("input_tokens"),
    "output_tokens": usage.get("output_tokens"),
    "cache_read_input_tokens": usage.get("cache_read_input_tokens"),
    "cache_creation_input_tokens": usage.get("cache_creation_input_tokens"),
    "duration_ms": result.get("duration_ms"),
    "num_turns": result.get("num_turns"),
}
with open(USAGE_LOG, "a") as f:
    f.write(json.dumps(record, ensure_ascii=False) + "\n")
作るときに気をつけたこと
- JSON として読めない出力(認証エラーなど)は、そのまま運用ログに出す:集計を壊さないことより、ログを欠かさないことを優先した
- 記録に失敗しても、ジョブ自体は失敗させない:エラーは標準エラーに出すだけ
- 人が読むログにも1行で残す:
[usage] job=night cost_usd=… input=… output=…のように
途中経過も残すようにした
あとから、AI が途中で自主的に処理を止めてしまい、最後の作業まで進まないことが何度か起きました。最終結果だけを記録していると、「何を確認しようとして止まったのか」が後から追えません。
そこで、イベント列をまるごと別ファイルに保存し、途中の発言とツールの呼び出しを人が読めるログにも書き出すようにしました。
[turns]
  [text] まず受付キューを確認します
  [tool_use] Bash(command=bash scripts/gh_issue.sh list ...)
計測してわかったこと
しばらく記録を続けると、96回分の実行がたまりました。ジョブ別に集計するとこうなります(コストは API 換算の参考値)。
| ジョブ | 回数 | コスト(参考) |
|---|---|---|
| 夜間シフト(整理・タスク処理) | 38回 | 約183ドル |
| 朝のレポート | 37回 | 約30ドル |
| 週次のコンテンツレビュー | 5回 | 約15ドル |
| 月次まとめ記事 | 4回 | 約12ドル |
| 週次まとめ記事 | 5回 | 約8ドル |
| 週次の記事候補の選定 | 7回 | 約5ドル |
夜間シフトが全体の7割以上を占めていました。回数は朝のレポートとほぼ同じなのに、1回あたりのコストが約6倍です。夜間シフトでは複数の AI 社員が順に起動され、タスクの整理や処理でたくさんのファイルを読んだりツールを呼んだりしています。
「何となく重そう」だったものが、数字で比べられるようになったのが一番の収穫だったかなと思います。
5時間枠の使用率が高かった理由
ある日、5時間ごとの利用枠が84%まで使われていたので調べました。定期実行のログと突き合わせると、主な原因は定期実行ではなく、自分が対話で使っていた分である可能性が高い、という結果でした。
ジョブごとの記録があったので、定期実行を一律に疑わずに済みました。
記録を始めてから見直したこと
夜間シフト:仕事がない担当は起こさない
夜間シフトの中身を見ると、3人のマネージャーが5晩続けて「自分のチーム宛てのタスクは0件」と確かめ、長い日報を書くだけで終わっていました。
そこで、キューに自分のチーム宛てのタスクがある夜だけ起こすように変えました。毎晩必ず動くのは4人になりました。
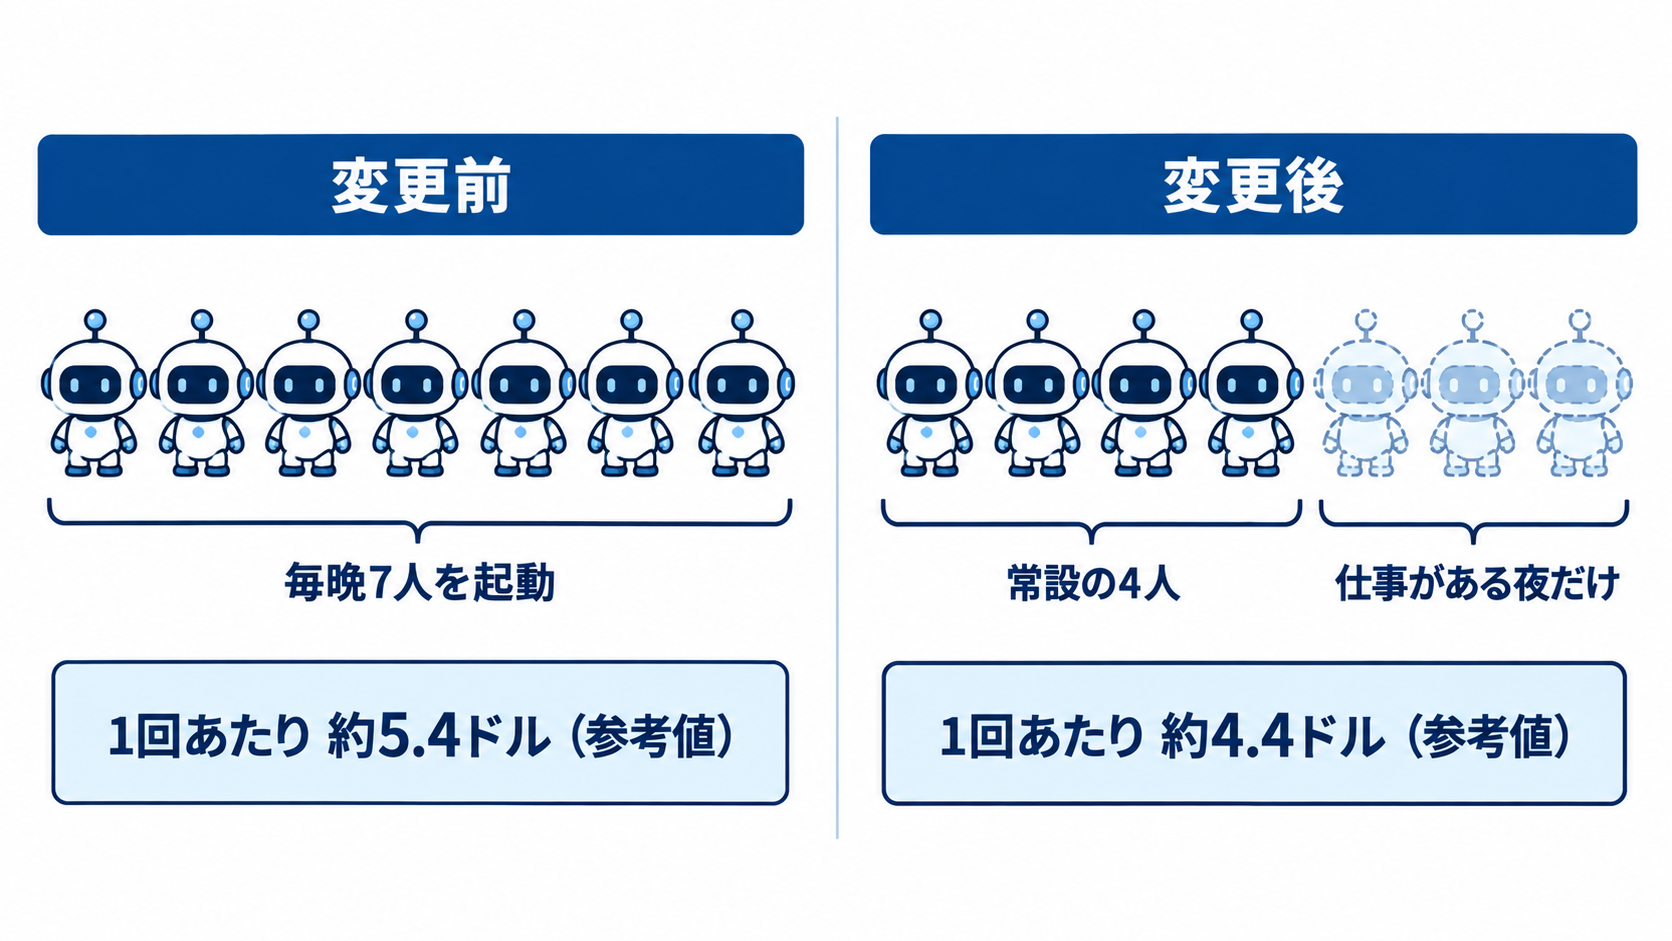
夜間シフトの1回あたりのコスト(参考値)は、変更の前後でこう変わりました。
| 期間 | 回数 | 1回あたり |
|---|---|---|
| 変更前 | 16回 | 約5.4ドル |
| 変更後 | 22回 | 約4.4ドル |
同じ日に、稼働していない AI 社員の停止もまとめてやったので、この変更だけの効果ではありませんが、2割ほど減りました。仕事がないことを確かめるだけでも、毎晩それなりのトークンを使っていたのだと思います。AI 社員を減らした話は、こちらの記事に書きました。
記事の執筆:1回の実行で1本ずつ
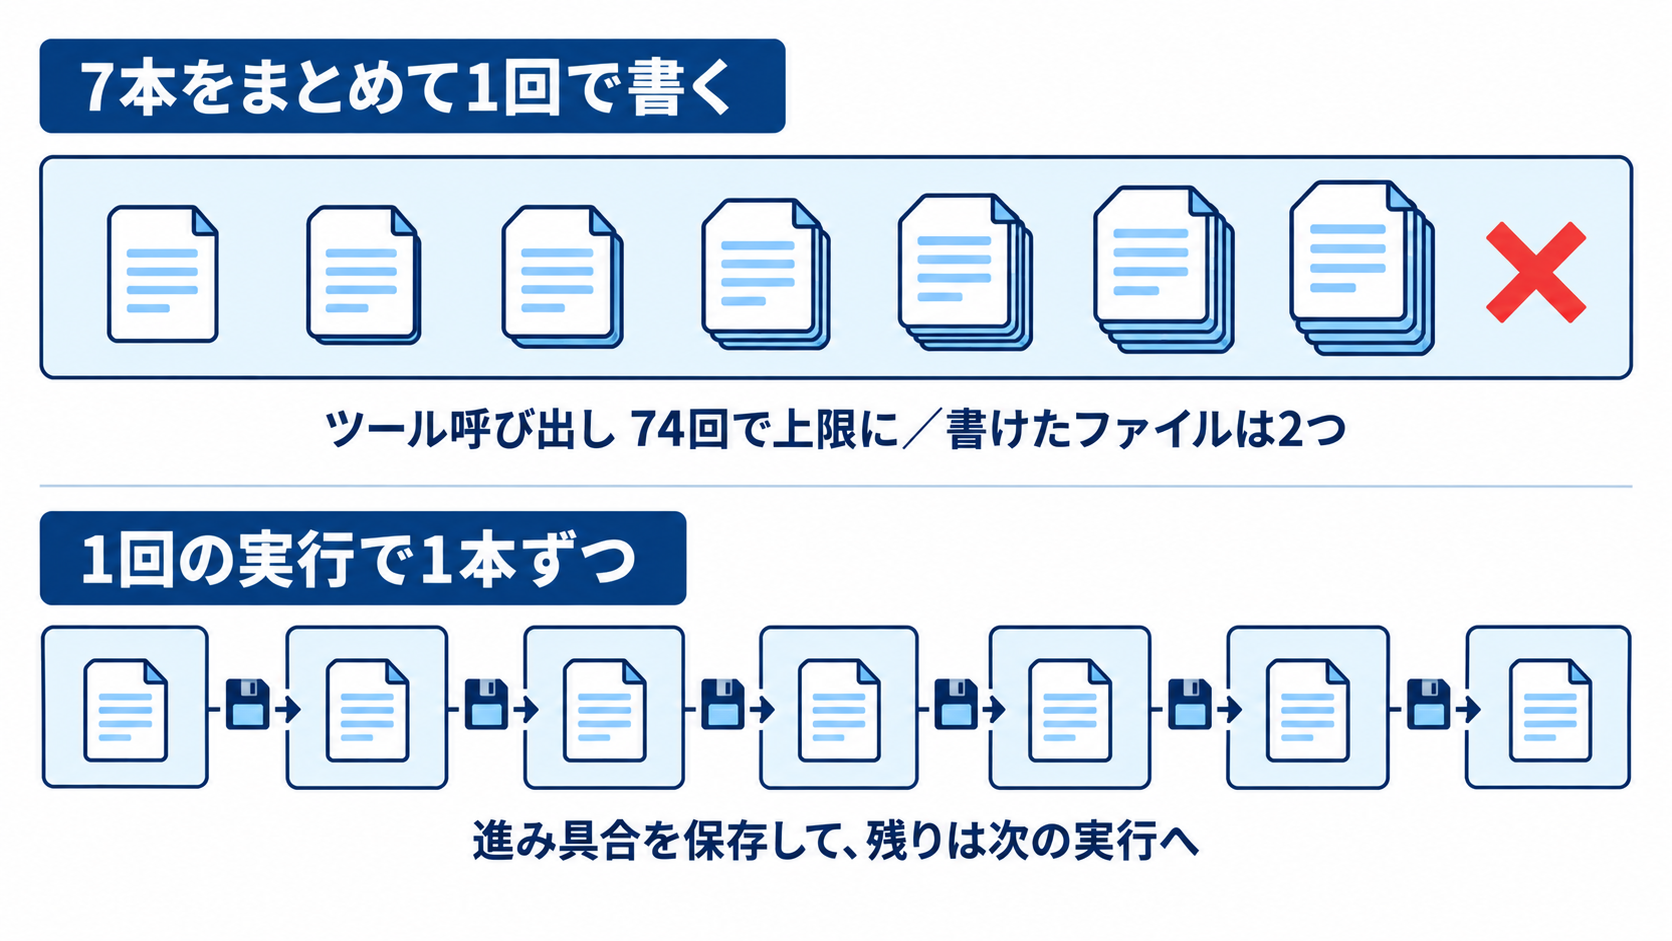
記事の執筆は、1回の実行で7本の候補をまとめて書かせていました。すると、前の記事を書いたときの作業がそのまま次の記事の文脈に積み上がり、自作のフックで決めていたツール呼び出しの上限にすぐ当たっていました(このときは役割の設定漏れで、本来より低い上限が使われていたことも重なっていました)。
実測では、7本のうちに Bash などのツールを74回呼び、ファイルを書けたのは2回だけでした。
そこで、1回の実行では1本だけ仕上げて進み具合を保存し、残りは次の実行に回す形に変えました。1本ずつなら毎回必ず前に進むので、失敗したときに全部を最初から書き直すこともなくなります。
朝のレポート:決まった集計はスクリプトでやる
朝のレポート担当も、自作のフックで決めていたツール呼び出しの上限(57回)に引っかかって途中で止まり、レポートが欠けたことがありました。レポートのためにファイルを1つずつ読んでいて、Read を38回、Bash を16回呼んだのに、書き込みは1回だけでした。
対策として、必要な情報を1回でまとめて集めるスクリプトを作り、AI にはその出力だけを読ませるようにしました。
AI に1ファイルずつ読ませるより、決まった集計はスクリプトでやって結果だけ渡すほうが、速くて安くて確実だと思います。
ファクトチェック:通す条件と止める条件を決めた
記事の品質を保つためのファクトチェックも、条件を決めました。記事のレビューを専任の担当から書いた本人に移したときに、次のようにしています。
- 数値・日付・製品仕様・時事を含む記事は、必ずファクトチェックを通す(自分で書いた記事の自己レビューでは、ここが一番甘くなりやすいため)
- 2回直しても同じ指摘が残る場合は、そこで止めて人間に回す(3回目の自己修正で品質が上がることは少ないため)
今の見方
記録は今も取り続けていますが、毎日見ているわけではありません。何か起きたら AI 社員の日報にアラートが上がるようにしているので、アラートが来ていなければ大丈夫だろう、と考えています。
数字を見るのは、何かを止める・増やすと決めるときや、利用枠がおかしいと感じたときくらいです。
おまけ:--allowedTools がプロンプトを飲み込む
claude -p を使うときにハマったことも書いておきます。
--allowedTools は可変長の引数を受け取ります。そのため、--allowedTools の直後に引数を置かずにプロンプトを書くと、プロンプトまで「許可するツール名」として飲み込まれてしまいます。
# NG: プロンプトが --allowedTools に飲み込まれる
claude --allowedTools "WebSearch" "記事を書いて" -p

# OK: プロンプトは -p の直後に置く
claude -p "記事を書いて" --allowedTools "WebSearch"
AI 社員を動かし始めたころ、これで最初のバッチ実行が全滅しました。以来、プロンプトは必ず -p の直後に置くようにしています。
まとめ
claude -p --output-format jsonで、1回ごとのトークン数とコスト(参考値)が取れる- ジョブ名を付けて JSONL に追記するだけで、どのジョブが重いかが比べられる
- 計測してみると、夜間シフトが全体の7割以上。一方、5時間枠を圧迫していたのは自分の対話である可能性が高かった
- 仕事がない担当を起こさない、記事は1本ずつ書く、決まった集計はスクリプトでやる、の3つで無駄を減らした
--allowedToolsの後ろにプロンプトを置かない
定期実行で Claude Code を動かしているなら、まずは記録を取るところから始めてみるのがいいかなと思います。止めるジョブも、残すジョブも、数字で判断できるようになります。
あわせて読みたい