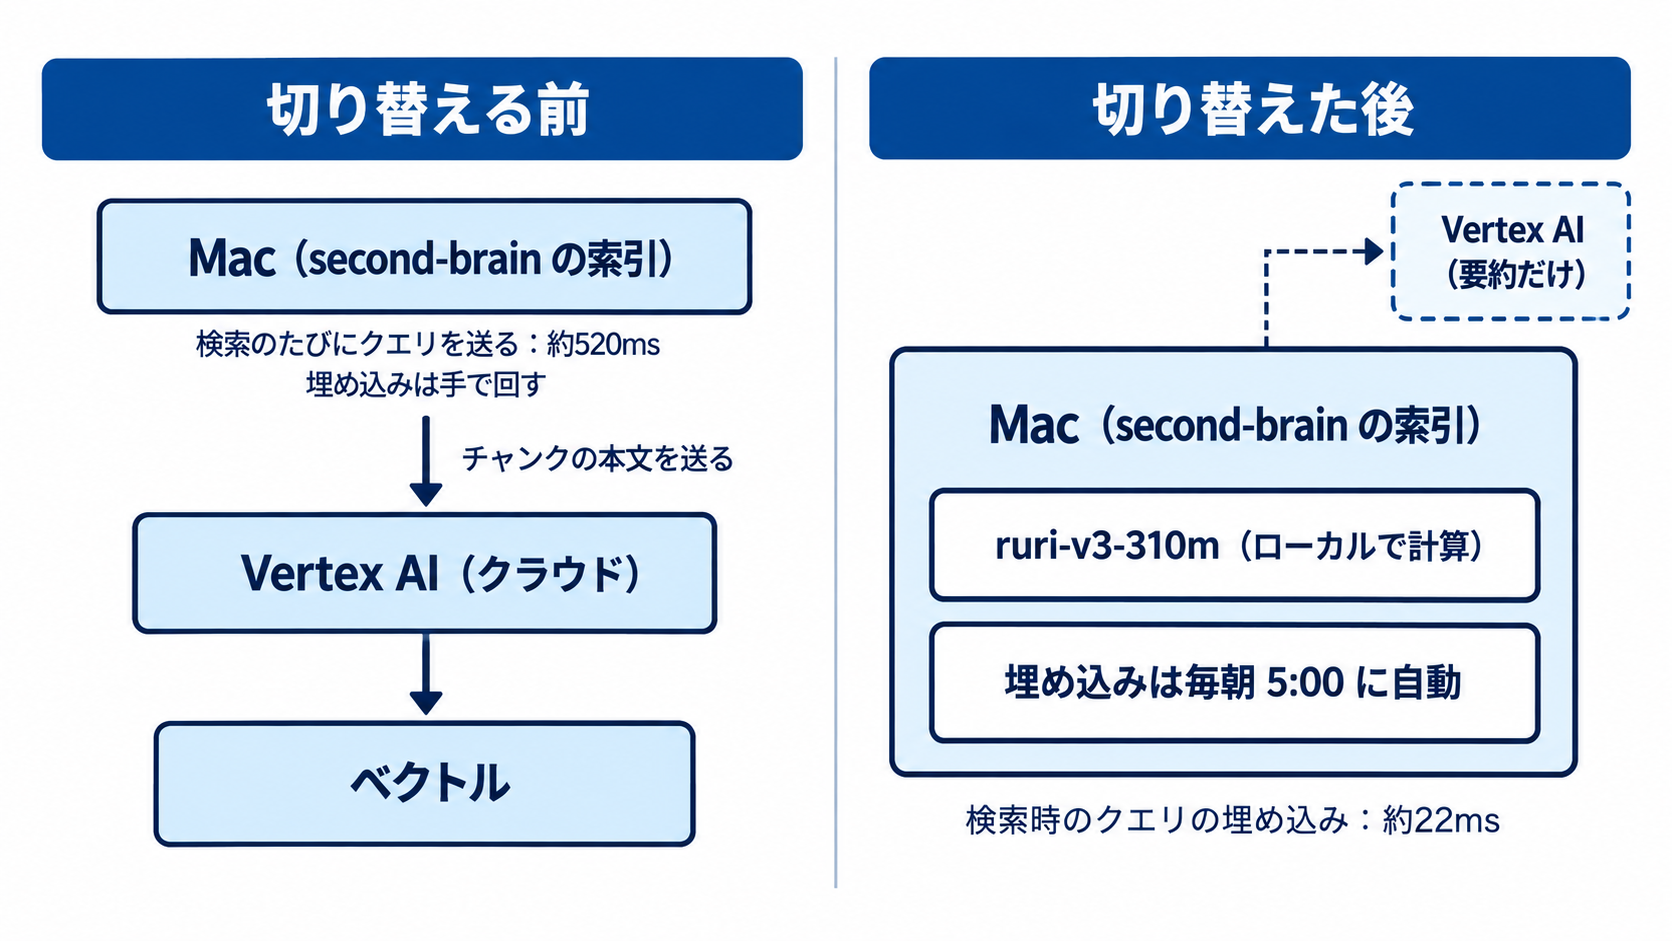
個人用のナレッジ検索基盤 second-brain(こちらの記事で紹介したもの)で、文章をベクトルにする「埋め込み」を、Vertex AI の API から、Mac の上で動く日本語のモデル ruri-v3-310m に替えました。
替える前に、4つのモデルを同じ30問で比べています。比べた結果と、替えて変わったことはこうでした。
- 精度:対象の文書を絞った比較で、ハイブリッド検索の正解が Vertex AI 23問、ruri 22問(30問中1問差)
- 速さ:検索のときのクエリの埋め込みが、約520ms から約22ms に
- お金:埋め込みの課金はなくなった(要約には今も Vertex AI を使っています)
ただ、切り替えてから12日後に全体で測り直すと、30問中25問まで下がっていました。調べると、主な原因は索引に文書が増えたことで、お題の作りがその影響を受けやすくしていました。この記事では、比べ方と結果、切り替えで気をつけたこと、測り直して分かったことを書こうかと思います。
替えようと思ったきっかけ
second-brain は、Obsidian のメモや Claude Code の会話ログを、全文検索とベクトル検索を組み合わせて探せるようにした仕組みです。ベクトル検索のために、各チャンク(文章を区切った断片)を Vertex AI の gemini-embedding-001(768次元)で埋め込んでいました。
作った当初は、埋め込みに Vertex AI を使うと決めていました。ナレッジは全部クラウドの API に送ってよいことにして、作りをいちばん単純にしていたためです。second-brain の「ローカルファースト」は、元データと索引を手元に置くという意味で、計算までローカルでやるという意味ではありませんでした。
ただ、使い続けるうちに、困ることが3つ出てきました。
- 埋め込みが追いついていなかった:索引の更新(
brain index)は毎時自動で回していましたが、埋め込み(brain embed)は手で回す作りにしていました。平日は仕事があって、この仕組みを毎日使うわけではないので、毎日 Vertex AI にお金をかけて埋め込むほどでもないと思っていたためです。金額は大きくなく、8月分の請求で埋め込みは ¥181 でした。その結果、作った当初に埋め込んだあとは回しておらず、埋め込みの対象(コード以外のチャンク)約6.9万のうち、あとから増えた約4.7万チャンクがベクトル検索に乗っていませんでした - 検索が遅い:検索するたびに、検索する文(クエリ)を API でベクトルにしていて、1回あたり実測で約520ms かかっていました。MCP 経由の検索で、ここが一番時間を食っていました
- 本文を外に送っている:個人のメモや会話ログを、埋め込みのたびにクラウドへ送っていました
そこで、Apple Silicon の Mac で速く動くローカルのモデルに替えられないか、考え直すことにしました。
候補の選び方:本命は Qwen3 だった
候補は、Claude Code に Web で最新の情報を調べてもらって、3つに絞りました。
| モデル | 種類 |
|---|---|
Qwen3-Embedding-0.6B |
多言語。モデルカードでコードの検索にも対応をうたっている |
microsoft/harrier-oss-v1-0.6b |
多言語。Microsoft のモデル |
cl-nagoya/ruri-v3-310m |
日本語に特化 |
下調べの段階で、日本語の検索なら ruri が強いという情報は出ていました。それでも最初の本命は Qwen3 でした。索引の大半はリポジトリから取り込んだファイルだったので、日本語だけでなくコードにも強いモデルが要ると考えたからです。
ところが、よく見ると埋め込みの対象はコード以外のチャンクだけでした。コードは全文検索だけで探していて、埋め込むのは日本語のドキュメントと会話ログが中心です。前提が違っていたので、決めずに測って選ぶことにしました。
比べ方
比較用のスクリプト(evals/embed_bakeoff.py)を書いて、同じ条件で4つを測りました。
- 共通の文書:Vertex AI で埋め込み済みだった 21,584 チャンク。全文検索もこの範囲に絞りました
- お題:もともと用意していた回帰お題30問(質問と、ヒットすべき文書の組)
- 指標:上位8件に正解が入るか(hit@8)
- vec-only:ベクトル検索だけ
- hybrid:全文検索(SQLite の FTS5)とベクトル検索を RRF で混ぜたもの
- ふだんかけているソースごとの重みと、古いものを下げる補正は外しました
ローカルの3つは sentence-transformers で読み込み、Mac の GPU(MPS)で fp16 で動かしています。マシンは M3・メモリ16GB の iMac です。
結果
| モデル | vec-only | hybrid | 検索時のクエリの埋め込み | 文書の埋め込みの速さ |
|---|---|---|---|---|
| Vertex AI gemini-embedding-001 | 23/30 | 23/30 | 521ms | — |
| ruri-v3-310m | 21/30 | 22/30 | 22ms | 約8件/秒 |
| Qwen3-Embedding-0.6B | 20/30 | 21/30 | 23ms | 約3〜5件/秒 |
| harrier-oss-v1-0.6b | 19/30 | 20/30 | 22ms | 約2〜5件/秒 |
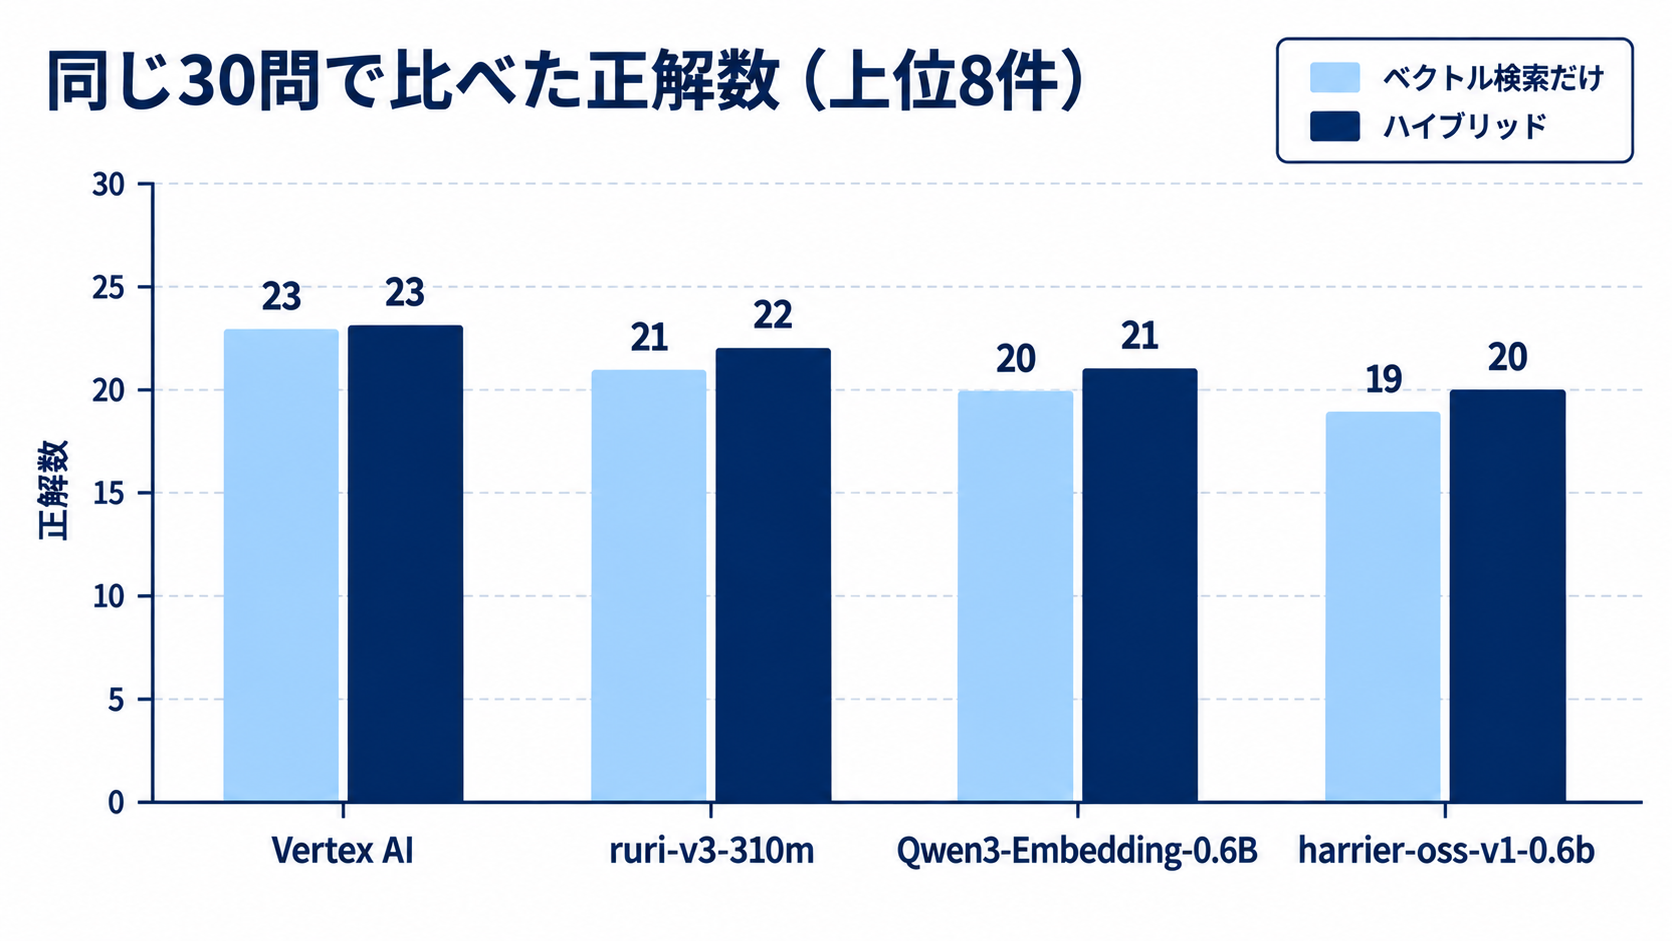
- 4つとも外した7問は、正解の文書が比較用に絞った文書の外にあったためと見ています。この7問を除いた23問では、Vertex AI が全問正解、ruri が1問ミスでした
- 日本語が中心のデータでは、日本語に特化した ruri(3億パラメータ)が、パラメータの多い多言語モデル(6億)より上でした。本命だった Qwen3 は3番目です。モデルの大きさより、データの言語に合っているかのほうが効いたのかなと思います
- ローカルの3つは、どれもクエリの埋め込みが約22ms でした
ruri は、全文検索と混ぜた hybrid にすると、Vertex AI との差が1問まで縮まります。もともと hybrid で使う前提なので、この差なら替えてもいいかなと思い、ruri にしました。
ruri の接頭辞
ruri-v3 は、モデルカードによると、用途によって文の先頭に付ける接頭辞を変える作りです。検索では、クエリに「検索クエリ: 」、文書に「検索文書: 」を付けます。second-brain では、モデルの設定と一緒に設定ファイルに書いています。
# config/models.yaml(抜粋)
embedding:
  provider: local
  model: cl-nagoya/ruri-v3-310m
  query_prefix: "検索クエリ: "
  document_prefix: "検索文書: "
接頭辞は、クエリを埋め込むか文書を埋め込むかに応じて、埋め込みの処理の中で付けています。呼ぶ側で付け忘れることはありません。
切り替えで気をつけたこと
モデルが変わったら、全部埋め込み直す
同じ768次元でも、モデルが違えばベクトルの意味はまったく違います。混ぜると検索結果が壊れるので、切り替えるときは全チャンクを埋め込み直しました(brain embed --rebuild)。
モデルの取り違えを検知する
索引には「どのモデルで埋め込んだか」を記録してあります。検索するときのモデルと一致しなければ、ベクトル検索を使わずに全文検索だけで返します。同じ次元のモデルどうしだとエラーにならず、結果だけがおかしくなるので、ここは仕組みで防ぐようにしました。
戻せるようにしておく
これまでの Vertex AI のベクトルは、モデル名ごとのキャッシュに残してあります。設定を戻して埋め込み直せば、そのぶんは API を呼ばずに戻せます。ただ、キャッシュに残っている Vertex AI のベクトルは 21,495 件で、今の索引のベクトル(70,746 件)の3割ほどです。今戻すなら、残りは API で埋め込むことになります。実際に戻したことはまだありません。
埋め込みは夜にまとめる
切り替えた日に、Mac のメモリの使用量が高いのが気になって、「これはいつ動いているのか」を Claude Code に聞きました。調べると、そのとき使っていたのは別のアプリで、ruri は動いていませんでした。ただ、ruri を読み込むとメモリを食うのは確かなので、埋め込みを毎時のジョブから外して、毎朝5:00のジョブにまとめました。会話ログの要約を作るジョブ(4:30)のあとなので、その日の要約も同じ朝に埋め込まれます。
切り替えてから測り直すまでに、このジョブは12回動いていて、どれも最後まで終わっていました。1回に新しく埋め込んだのは 29〜622 チャンクです。
得たもの・失ったもの
得たもの
- 埋め込みの課金がなくなった。毎日自動で埋め込めるようになり、未処理がたまらなくなった
- 埋め込みのために本文を外へ送らなくなった。要約(Gemini 2.5 Flash-Lite)では、今も会話の中身を Vertex AI に送っています
- クエリの埋め込みが約24倍速くなった(約520ms → 約22ms)。測り直したときも、20回の中央値で 19ms でした
失ったもの
- 比較では、hybrid で 1問分の精度
- メモリ。モデルを読み込んだプロセス1つで、測ってみると最大で約1.8GB 使っていました。検索の MCP サーバーは、Claude Code のセッションごとに1つずつ起動し、最初にベクトル検索をしたときにモデルを読み込みます。セッションを開いたままにしておくと、そのぶん増えます
- 最初の1回が遅い。モデルを読み込んで1回目の埋め込みが終わるまで、約5.8秒かかりました
- その日に追加した文書は、翌朝まで全文検索でしか見つからない(埋め込みを朝にまとめたため)
- 最初の1回だけ、モデルを取ってくるために Hugging Face Hub につなぐ必要がある
使い心地のほうは、まだよく分かっていません。検索は MCP 経由で Claude Code が呼ぶので、いつ使われているのかが自分では分かりにくく、最近は自分で検索することも少なかったからです。替える前もそれほど使っていなかったので、体感の差は言えない状態です。
切り替えてから12日後に測り直したら、25/30 に下がっていた
second-brain の記事では「替えたあとの全体での測り直しは、まだしていません」と書いていました。そこで、今の索引全体で、同じ30問を測り直しました。
| いつ | 埋め込み | 全文検索だけ | hybrid |
|---|---|---|---|
| 検索を作った当初 | Vertex AI | 25/30(83%) | 29/30(97%) |
| ruri に替えて12日後 | ruri-v3-310m | 12/30 | 25/30 |
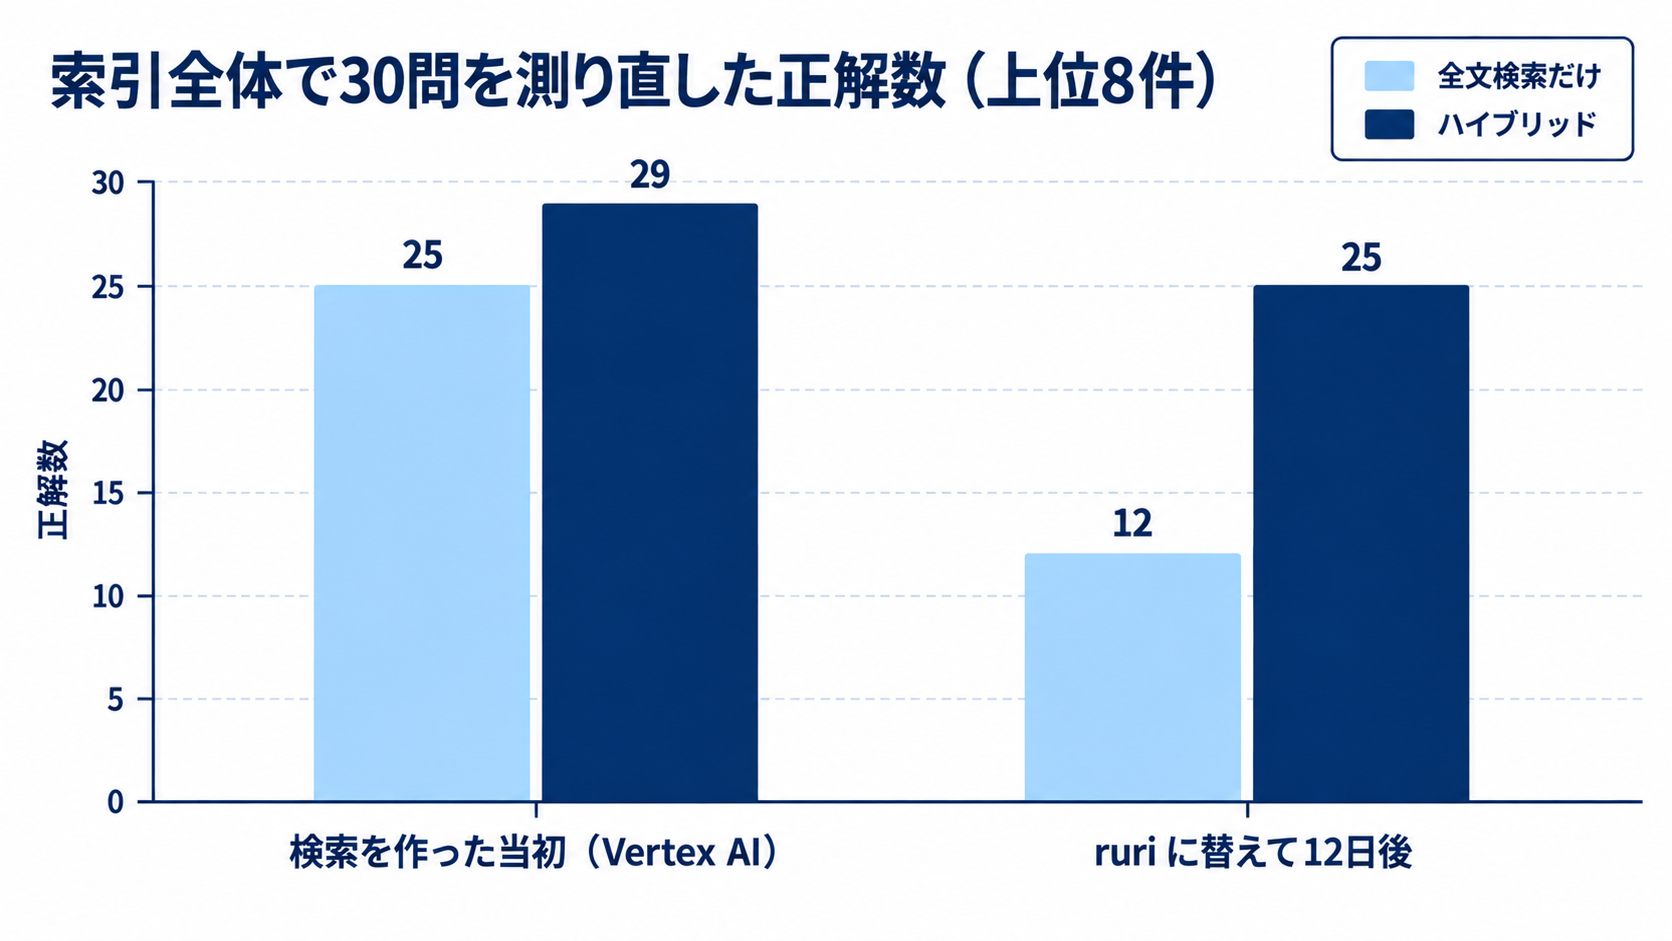
hybrid は 29問から25問に下がりました。全文検索だけの結果は 25問から12問と、もっと大きく下がっています。全文検索はモデルを替えても変わらないので、下がった理由の多くは、モデルではなく索引の側にありそうです。
外した5問について、正解の文書が何位にいて、何が上に来ているかを見ました。正解の文書は、5問とも索引に残っていました。
| 外した問題 | 正解の順位 | 上に来ていたもの |
|---|---|---|
| OKF のフロントマターの規約 | 22位 | あとから索引に入れた Hermes Agent のリポジトリのドキュメント。同じものが2か所に入っていた(リポジトリと、デスクトップアプリに入っているコピー) |
| MCP ツールの readOnlyHint の定義 | 12位 | 同じく Hermes Agent のドキュメント(2か所分)と、MCP サーバーのリポジトリでの会話ログ |
| Plaud の文字起こしの精度を上げる方法 | 17位 | ruri に切り替えたときの会話ログ(お題のファイルの中身と、比べたときの出力に、この質問の文がそのまま入っていた)、関連するドキュメント |
| AI社員の就業規則 | 31位 | AI社員の記事を書いたときの会話ログ、毎朝のレポート |
| AI秘書の記憶・検索の設計の依頼(会話ログに絞った問題) | 50位以内に入らない | 同じ設計の話をしていた、別のプロジェクトの会話ログ |
いちばん大きいのは、あとから増えた文書が、正解より上に来ていることでした。索引は約3.4万文書・13.5万チャンクまで増えていて、Hermes Agent のリポジトリ(しかも2か所に重複して入っている)や、同じ話題を話した会話ログが上に来ています。全文検索の作りは、検索を作った当初から変えていません。
そのうえで、お題の作りに、文書が増えると崩れやすいところが2つありました。どちらも最初からあったもので、索引が小さいうちは目立たなかったのだと思います。
- お題のファイルそのものが索引に入っている:30問を書いた
evals/questions.yamlが、外した5問のうち4問で正解より上に来ていました。質問の文がそのまま書いてあるファイルなので、上に来るのは当然です。お題の中身や測った結果を貼った会話ログも、あとから索引に入っていきます - 正解を1つの文書に決めている:元の文書の内容を話している会話ログが上に来ると、それも外れになります。30問は、検索を作った当初の索引に合わせて作ったものでした
一方で、同じ索引で全文検索だけにすると 12問、ruri のベクトル検索を混ぜると 25問なので、ベクトル検索で13問を拾えています。
Vertex AI と ruri のどちらが良いかは、この測り直しからは分かりません。今の索引で Vertex AI と比べるには、あとから増えた分を API で埋め込む必要があるので、今回はやっていません。同じ条件で比べた結果は、上の 21,584 チャンクに絞った比較だけです。
固定のお題は、索引が育つと、同じ30問でも測れるものが変わってしまうようです。お題のファイルを索引から外すことや、正解を複数持たせることなど、測り方を見直してから、また測ってみようと思っています。
まとめ
- 埋め込みを Vertex AI から、ローカルの日本語モデル ruri-v3-310m に替えた
- 本命は、コードにも強い Qwen3 だった。ただ、埋め込む対象は日本語が中心だったので、測ってみると ruri が上だった
- 比べた条件では hybrid で30問中1問差。埋め込みの課金はなくなり、クエリの埋め込みは約22ms になった
- 代わりに、メモリ(1プロセス最大約1.8GB)と、その日に足した文書が翌朝まで全文検索でしか見つからないことを受け入れた
- 切り替えて12日後に全体で測り直すと 25/30。主な原因は索引が増えたことで、お題の作りがその影響を受けやすくしていた
埋め込みのモデルを選ぶときは、評判や大きさで決めずに、まず手元のデータで小さく比べてみるのがよいと思います。今回は、本命が3番目になりました。比べたあとも、お題が今の索引に合っているかは、ときどき確かめたほうがよさそうです。
あわせて読みたい